10월 프리뷰와 이번 가중치 공개의 차이
AI 코딩 모델을 고를 때 성능표만큼 중요한 것이 요청 한 번을 끝내는 데 쓰는 토큰입니다. 미스트랄은 10월 29일 Large 4의 개선된 가중치를 공개하면서 코딩 작업 성능과 토큰 효율을 함께 내세웠습니다. API 요금도 입력 100만 토큰당 0.70달러, 출력 100만 토큰당 2.10달러로 제시했습니다. 모델 파일을 직접 운영할지, 필요한 만큼 API로 호출할지 비교할 수 있는 선택지가 늘었습니다.
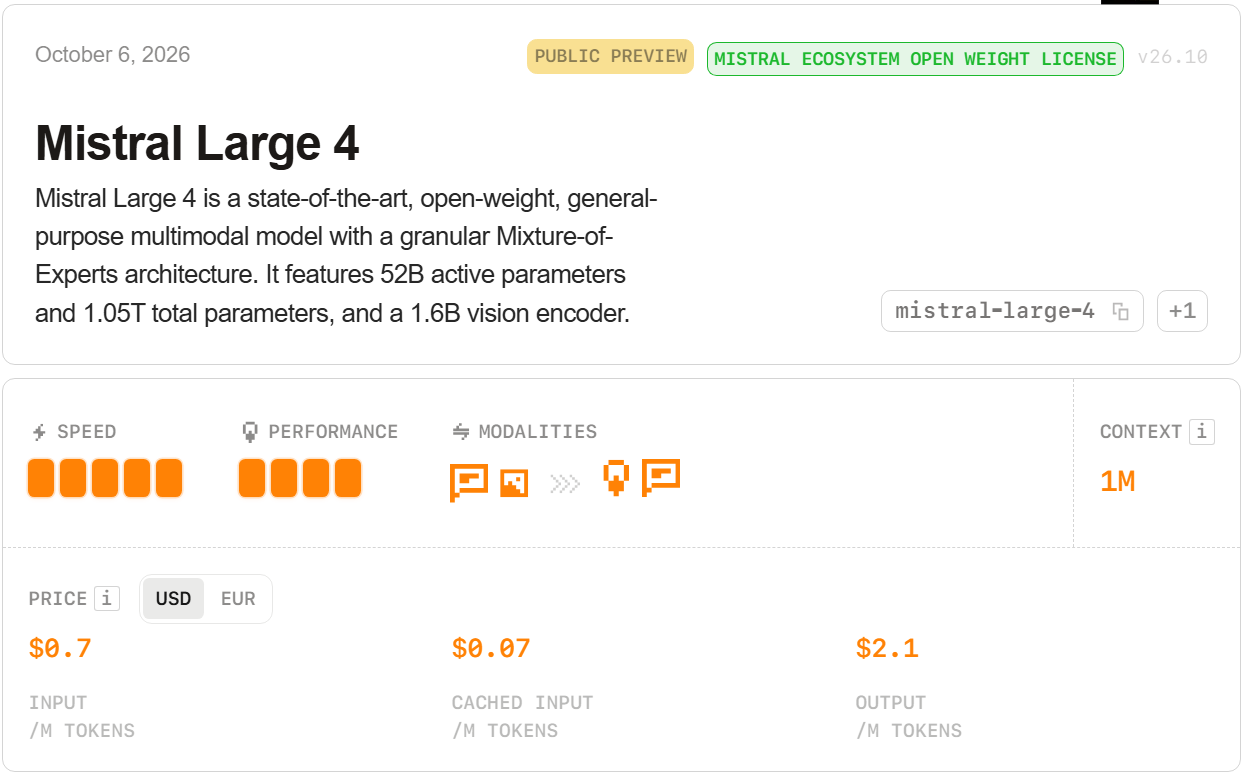
이번 발표를 완전히 새로운 모델의 최초 출시로 읽으면 날짜가 어긋납니다. 공식 모델 문서에는 2026년 10월 6일 Public Preview와 버전 26.10이 표시돼 있습니다. 이번에 공개한 것은 그 프리뷰에 추가 강화학습을 진행해 개선한 모델의 가중치입니다. 기존 프리뷰를 써 본 사람은 모델 이름이 같더라도 평가 결과와 추론 설정이 달라졌다는 점을 봐야 합니다.
가중치 공개는 서비스 접속 권한과도 다릅니다. API나 Studio를 통해 공급자가 운영하는 모델을 호출하는 방법과, Hugging Face에서 모델 파일을 받아 자체 인프라에 배포하는 방법이 동시에 제공됩니다. 다운로드가 가능하다는 이유로 노트북에서 부담 없이 실행되거나 호출 비용이 사라지는 것은 아닙니다. 먼저 어떤 운영 경로를 원하는지 정한 뒤 요금과 장비를 비교하는 편이 맞습니다.
Today, we release the weights of a new and improved Le Chonk, advancing the open frontier for agentic coding and cybersecurity.
— Mistral AI (@MistralAI) 2026년 10월 29일
1조 매개변수와 100만 토큰 문맥의 의미
Large 4는 여러 전문가 모듈 중 일부만 골라 계산하는 MoE 구조입니다. 공식 문서는 총 1.05조 매개변수, 활성 520억 매개변수와 16억 매개변수의 시각 인코더를 적고 있습니다. 모델 카드는 1조 규모, 토큰당 활성 490억이며 임베딩과 출력 층까지 포함하면 520억이라고 설명합니다. 두 숫자는 같은 범위를 세는 수치가 아니므로 490억과 520억을 서로 다른 모델 사양처럼 비교하면 안 됩니다.
입력은 텍스트와 이미지, 출력은 텍스트입니다. 따라서 사진이나 도표, 문서 내용을 읽고 코드나 설명을 돌려주는 작업에 쓰는 모델이지, 이 모델 자체가 이미지를 생성한다는 뜻은 아닙니다. 함수 호출과 JSON 스키마를 따르는 구조화 출력도 제공해 애플리케이션이 결과를 다음 단계로 넘기도록 만들 수 있습니다. 일반 대화와 추론, 코딩, 도구 사용을 한 가중치 안에서 처리합니다.
최대 문맥은 100만 토큰입니다. 긴 저장소나 여러 문서를 한 요청에 넣을 공간이 넓다는 뜻이지만, 문맥 크기가 곧 정확도나 무료 처리량은 아닙니다. 입력을 많이 넣으면 입력 요금이 늘고, 모델이 긴 답을 쓰면 출력 요금이 따로 붙습니다. 긴 문서를 읽는 서비스라면 최대 길이부터 채우기보다 실제 질문에 필요한 자료를 골라 넣었을 때 결과와 비용이 어떤지 비교할 필요가 있습니다.
API 요금과 캐시 입력 비용 계산
공식 발표와 API 문서의 달러 표시가 일치하는 단가는 100만 토큰당 입력 0.70달러, 캐시 입력 0.07달러, 출력 2.10달러입니다. 입력과 출력은 별도 항목입니다. 입력 단가만 보고 작업 전체를 0.70달러에 처리한다고 계산하면 답변 생성 비용이 빠집니다. 외부 도구나 다른 공급자의 엔드포인트를 같이 쓰는 경우에는 그 서비스의 별도 요금도 구분해야 합니다.
예를 들어 일반 입력 100만 토큰과 출력 10만 토큰을 쓴다면, 발표한 단가를 단순 적용한 모델 토큰 비용은 0.70달러에 0.21달러를 더한 0.91달러입니다. 입력 100만 토큰 전부가 캐시 입력으로 과금된다는 조건에서는 0.07달러에 출력 0.21달러를 더해 0.28달러입니다. 실제 캐시 적용 조건과 비율이 충족되지 않은 요청에 이 낮은 비용을 그대로 대입해서는 안 됩니다.
이 계산은 월 구독료나 일정 사용량을 보장하는 정액제 설명이 아닙니다. 모델을 직접 호스팅하면 API 단가 대신 GPU와 메모리, 운영 인력, 전력과 서버 비용을 부담합니다. 사용량이 작거나 들쭉날쭉한 팀은 API부터, 데이터 통제와 일정한 대규모 처리가 중요한 조직은 자체 배포까지 검토하는 식으로 출발점이 달라집니다. 가중치가 공개됐다는 사실과 운영비가 없다는 말은 구분해야 합니다.
세 가지 추론 모드와 토큰 효율 수치
추론 노력은 low, medium, high 세 단계이며 기본값은 high입니다. 공식 발표는 low를 단순 작업, medium을 일상 작업, high를 높은 정확도와 깊은 추론이 필요한 작업에 권합니다. 기존 None 추론 모드는 low가 대신합니다. 같은 모델을 쓰더라도 요청마다 추론 설정을 다르게 잡을 수 있어, 짧은 분류와 복잡한 수정 작업을 모두 가장 무거운 설정으로 보낼 필요는 없습니다.
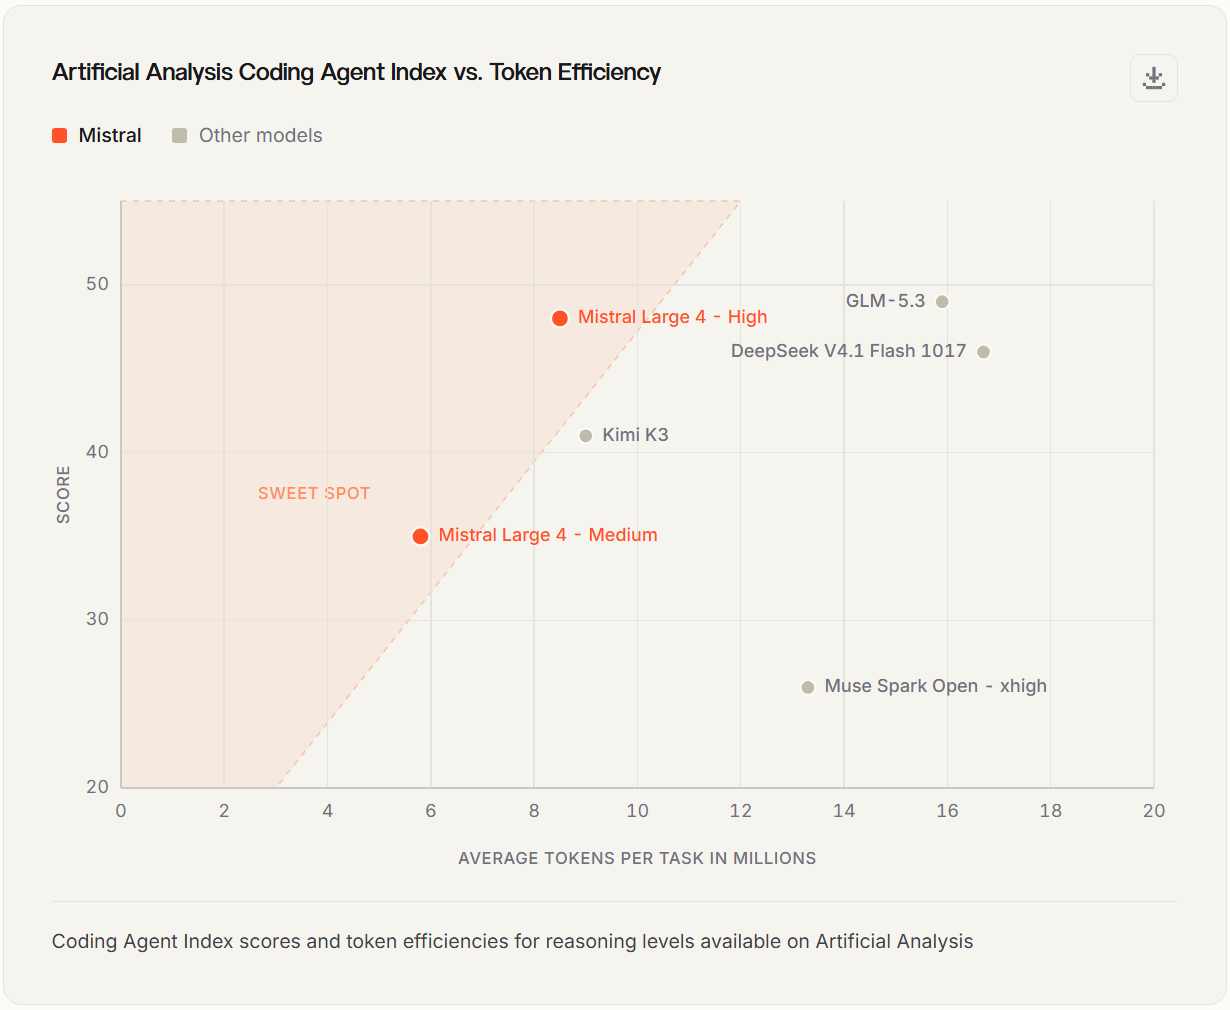
미스트랄은 Artificial Analysis Coding Agent Index에서 48%를 기록하면서 GLM-5.3보다 작업당 평균 토큰을 47% 적게 썼다고 발표했습니다. 발표 차트의 High 설정은 작업당 평균 850만 토큰, 점수 48이고, GLM-5.3은 1,590만 토큰, 점수 49입니다. 여기서 비슷한 점수라는 표현은 모든 작업에서 결과가 같다는 뜻이 아닙니다. 전체 벤치마크의 집계값과 각 개발팀의 실제 코드 수정은 구분해서 봐야 합니다.
Medium 설정은 같은 차트에서 평균 580만 토큰과 점수 35로 표시됩니다. 토큰 사용량을 줄이는 대신 그 시험에서는 성능도 낮아지는 관계가 드러납니다. 기본 high가 항상 최선이거나 medium이 언제나 경제적이라고 단정할 수는 없습니다. 반복 업무에서 성공 조건을 먼저 정하고, 같은 요청 묶음을 설정별로 비교해 통과한 작업 하나당 비용을 보는 편이 단가 비교보다 도움이 됩니다.
코딩 벤치마크에서 읽어야 할 범위
Cognition의 비공개 FrontierCode 2.0 시험에서 Large 4는 19.7%로 제시됐습니다. 이 시험은 코드를 단순히 실행하는 것뿐 아니라 저장소 관리자가 변경을 병합할 만한지를 평가하는 방향입니다. 서로 다른 시험의 백분율을 한 표에서 같은 정답률처럼 읽으면 안 됩니다. 19.7이라는 숫자가 일반 코딩 요청의 성공률을 뜻하거나, 앞의 Coding Agent Index 48과 바로 비교되는 수치도 아닙니다.
터미널 작업을 평가하는 Terminal-Bench 4.0에서는 공개 프리뷰의 약 28%에서 약 41%로 개선됐으며 출력 토큰은 30% 줄었다고 미스트랄이 밝혔습니다. 이 역시 제작사 발표에 실린 평가 결과입니다. 독자가 실행한 재현 실험과 구분해야 하고, 오래된 프리뷰와 새 공개 가중치의 비교라는 점도 함께 붙어야 합니다. 개선 폭만 떼어 다른 버전의 모델이나 다른 시험과 비교해서는 안 됩니다.
코드에 대한 사람의 선호 시험에서도 모든 상대를 앞선 것은 아닙니다. 공식 발표의 Surge Code 차트는 GLM-5.3과 Kimi K3, DeepSeek V4.1 Flash보다 Large 4를 선호하는 비율이 높았지만, Claude Opus 5.5를 상대로는 Large 4의 선호 비율이 22%라고 보여 줍니다. 특정 코딩 시험에서 선두라는 말과 개발자가 모든 결과를 더 좋아한다는 주장은 서로 다릅니다. 모델을 교체할 때는 자신의 테스트와 리뷰 기준을 적용해야 합니다.
근거 [1]
상업 이용을 허용하지만 모델 서비스 사업은 별도 계약
모델에 붙은 이름은 Mistral Ecosystem Open-Weight License입니다. MIT를 수정한 라이선스로 사용과 복사, 수정, 재배포, 추가 학습과 파생 모델 제작을 허용합니다. 모델이나 상당 부분을 배포할 때에는 저작권과 허용 고지를 포함해야 합니다. 단순히 MIT라는 단어가 보인다고 통상의 MIT와 조건이 같다고 처리하면 중요한 예외를 놓칩니다.
핵심 예외는 이용자 또는 계열사가 Model as a Service 사업을 운영하는 경우입니다. 이 경우 모델이나 파생 모델을 상업적으로 사용하기 전에 미스트랄과 별도 상업 라이선스를 체결해야 합니다. 원문은 제3자가 입력이나 매개변수, 학습 데이터에 의미 있는 통제를 행사할 수 있게 모델 추론이나 후학습에 접근하도록 제공하는 서비스를 그 범위로 설명합니다. 자체 API를 열어 모델을 제공하려는 사업자라면 이 정의부터 검토해야 합니다.
예외 조항의 제외 대상도 있습니다. 특정 기능이나 작업 틀 안에만 모델 기능이 내장된 최종 사용자 제품, 다른 곳에 호스팅된 모델로 요청을 단순 중계하는 경우는 Model as a Service 정의에서 제외합니다. 내부 사용과 미스트랄 공식 제품을 통해 접근하는 사용에는 해당 별도 계약 요구가 적용되지 않는다고 적혀 있습니다. 제품 이름이 아니라 실제 제공 방식과 제3자의 통제 범위가 기준이므로, 경계가 불분명한 사업은 계약 조건을 문의하는 편이 맞습니다.
근거 [4]
개발자가 선택할 수 있는 이용 경로
관리형 경로는 Mistral Studio와 API, OpenRouter가 제시돼 있고, Microsoft Foundry에도 배포 선택지가 있습니다. 코딩 에이전트 Vibe Code에서 자기 저장소의 기능 구현이나 버그 수정을 맡기는 방법도 소개합니다. 여기서 공급자가 달라지면 지원 옵션과 데이터 처리 조건, 과금 조건도 달라질 수 있으므로 미스트랄 공식 API 단가를 모든 경로에 자동으로 적용해서는 안 됩니다.
자체 배포 경로는 Hugging Face 모델 카드와 vLLM, SGLang 안내로 이어집니다. 별도로 NVFP4 양자화 체크포인트도 공개돼 있고 이 버전은 Blackwell GPU를 대상으로 합니다. 공식 모델 카드에는 Transformers와 llama.cpp 등 다른 실행 체계의 안내도 연결돼 있습니다. 활성 매개변수가 520억이라는 숫자만으로 필요한 GPU 메모리를 계산하면 전체 가중치 저장과 문맥 처리 비용을 놓치므로, 실제 배포 문서와 대상 하드웨어 조합을 먼저 봐야 합니다.
모델 카드는 공개 첫 주 동안 공식 데모에 방문자별 소규모 공동 무료 예산을 제공한다고 안내합니다. 영구 무제한 무료 API가 아니라 기간과 예산이 있는 체험 경로입니다. 먼저 공개 데모에서 자신의 작업과 비슷한 입력을 살펴본 뒤 API를 검토하고, 자체 배포는 라이선스와 장비를 갖춘 뒤 진행하는 순서로 선택할 수 있습니다. 이번 공개의 실익은 대형 모델을 누구나 가볍게 설치한다는 데 있지 않고, 공급자 API에만 의존하지 않는 운영 경로가 열렸다는 데 있습니다.