Kronos가 하는 일: 주가 차트를 문장처럼 읽는 모델
Kronos는 주식이나 코인 차트의 봉(캔들) 데이터만 따로 배운 오픈소스 기반 모델입니다. 챗GPT 같은 언어 모델이 앞 문장을 보고 다음 단어를 고르듯, Kronos는 시가와 고가, 저가, 종가, 거래량으로 된 봉 하나하나를 단어처럼 바꾼 뒤 다음 봉을 이어서 써 내려갑니다. 2025년 7월 저장소가 열렸고 8월에 논문이 나왔으며, 저장소 안내에 따르면 2025년 11월 AAAI 2026 학회 논문으로 채택됐습니다.
학습량이 꽤 큽니다. 논문에는 전 세계 45개 거래소에서 모은 봉 데이터 120억 건 이상으로 사전 학습했다고 적혀 있습니다. 저장소는 MIT 라이선스라 개인도 회사도 자유롭게 받아 쓸 수 있고, 이번 주 깃허브 주간 트렌딩에 올라오면서 별이 4만 7천 개를 넘었습니다. 허깅페이스 집계로는 Kronos-small 모델의 최근 30일 내려받기가 240만 회를 넘었습니다.
작동 방식은 두 단계입니다. 먼저 전용 토크나이저가 연속된 가격과 거래량 숫자를 몇 단계로 나눈 기호로 바꾸고, 그다음 트랜스포머 모델이 그 기호를 하나씩 이어 붙이며 미래 구간을 만듭니다. 그래서 결과가 정답 하나로 나오지 않습니다. 같은 차트를 넣어도 뽑을 때마다 조금씩 다른 미래 경로가 나오고, 여러 번 뽑아 평균을 내거나 퍼진 정도를 보는 식으로 씁니다. 뒤에서 볼 삼성전자 결과를 읽을 때 이 점이 가장 중요합니다.
공개된 모델은 세 가지이고 가장 큰 Kronos-large는 공개되지 않았습니다. 일반 PC에서 써 볼 만한 것은 mini와 small입니다. small과 base는 한 번에 볼 수 있는 길이가 512개 봉이라, 이보다 긴 데이터를 넣으면 앞부분이 자동으로 잘립니다.
| 모델 | 크기 | 한 번에 보는 길이 | 공개 |
|---|---|---|---|
| Kronos-mini | 410만 매개변수 | 2,048개 봉 | 공개 |
| Kronos-small | 2,470만 매개변수 | 512개 봉 | 공개 |
| Kronos-base | 1억 230만 매개변수 | 512개 봉 | 공개 |
| Kronos-large | 4억 9,920만 매개변수 | 512개 봉 | 비공개 |
저장소 README의 모델 목록. mini는 전용 토크나이저 2k, 나머지는 base 토크나이저와 짝을 이룬다.
Kronos 설치: 파이썬 3.10과 requirements 한 줄
설치 자체는 단순합니다. README가 요구하는 것은 파이썬 3.10 이상이고, 저장소를 받은 뒤 requirements 파일로 의존성을 깔면 끝납니다. 목록에는 PyTorch, pandas, numpy, einops, huggingface_hub, matplotlib, tqdm, safetensors가 들어 있습니다. 그래픽카드가 없어도 됩니다. 이번에는 4코어 CPU에 메모리 8GB인 윈도우 서버의 WSL 우분투 안에서 설치했고, PyTorch는 용량을 줄이려고 CPU 전용판을 먼저 깔았습니다.
모델 파일은 따로 받을 필요가 없습니다. 코드에서 모델 이름을 부르면 허깅페이스에서 자동으로 내려받고, 토크나이저와 Kronos-small을 합친 캐시 폴더는 약 141MB였습니다. 첫 실행 때 내려받기와 불러오기를 합쳐 45초 정도 걸렸고, 그다음부터는 캐시를 씁니다.
처음 막히는 곳은 예제 데이터입니다. README와 예제 스크립트는 저장소 안의 data 폴더에 있는 중국 주식 5분봉 CSV를 읽도록 되어 있는데, 지금 master 브랜치에는 data 폴더가 없습니다. 그래서 예제를 그대로 돌리면 파일을 못 찾고 멈춥니다. 내 데이터를 넣으면 되는데, 형식은 timestamps, open, high, low, close 열이 필수이고 volume과 amount는 있으면 넣습니다. amount가 없으면 코드가 거래량과 평균 가격을 곱해 채웁니다.
이번 시험에는 네이버페이 증권의 삼성전자 일별 시세를 썼습니다. 2024년 1월 2일부터 2026년 11월 6일까지 693거래일의 시가, 고가, 저가, 종가, 거래량을 CSV 한 장으로 만들어 data 폴더에 넣었습니다.
git clone https://github.com/shiyu-coder/Kronos.git
cd Kronos

# 그래픽카드가 없는 PC라면 CPU판 PyTorch를 먼저 설치
pip install --index-url https://download.pytorch.org/whl/cpu torch

# 나머지 의존성
pip install -r requirements.txt삼성전자 일봉으로 돌려 본 결과: 급락한 20거래일
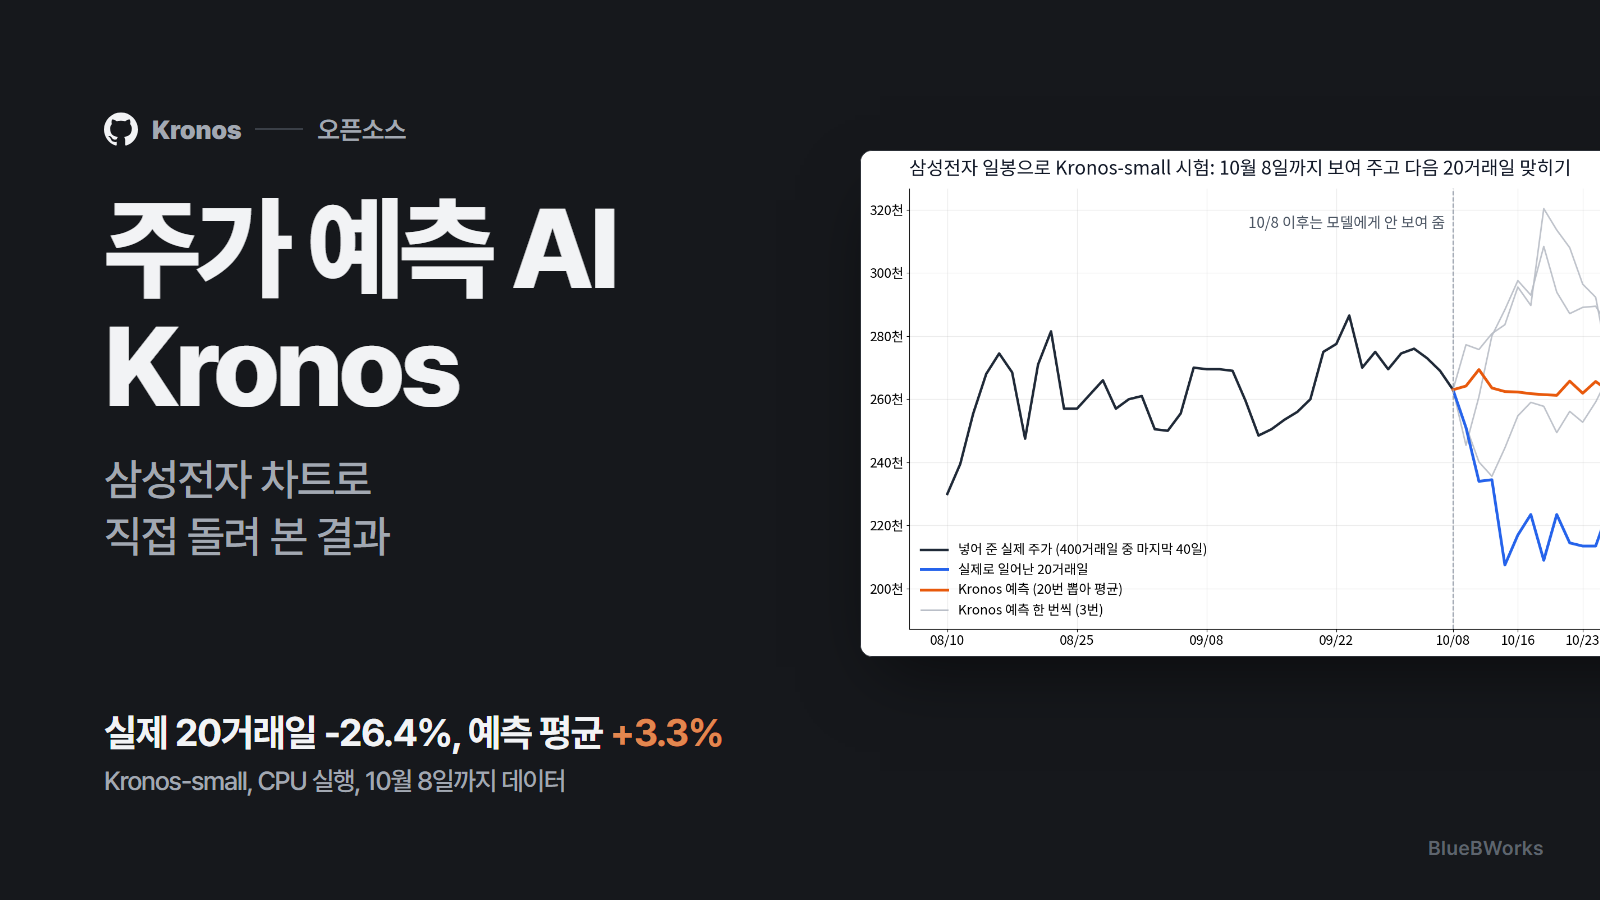
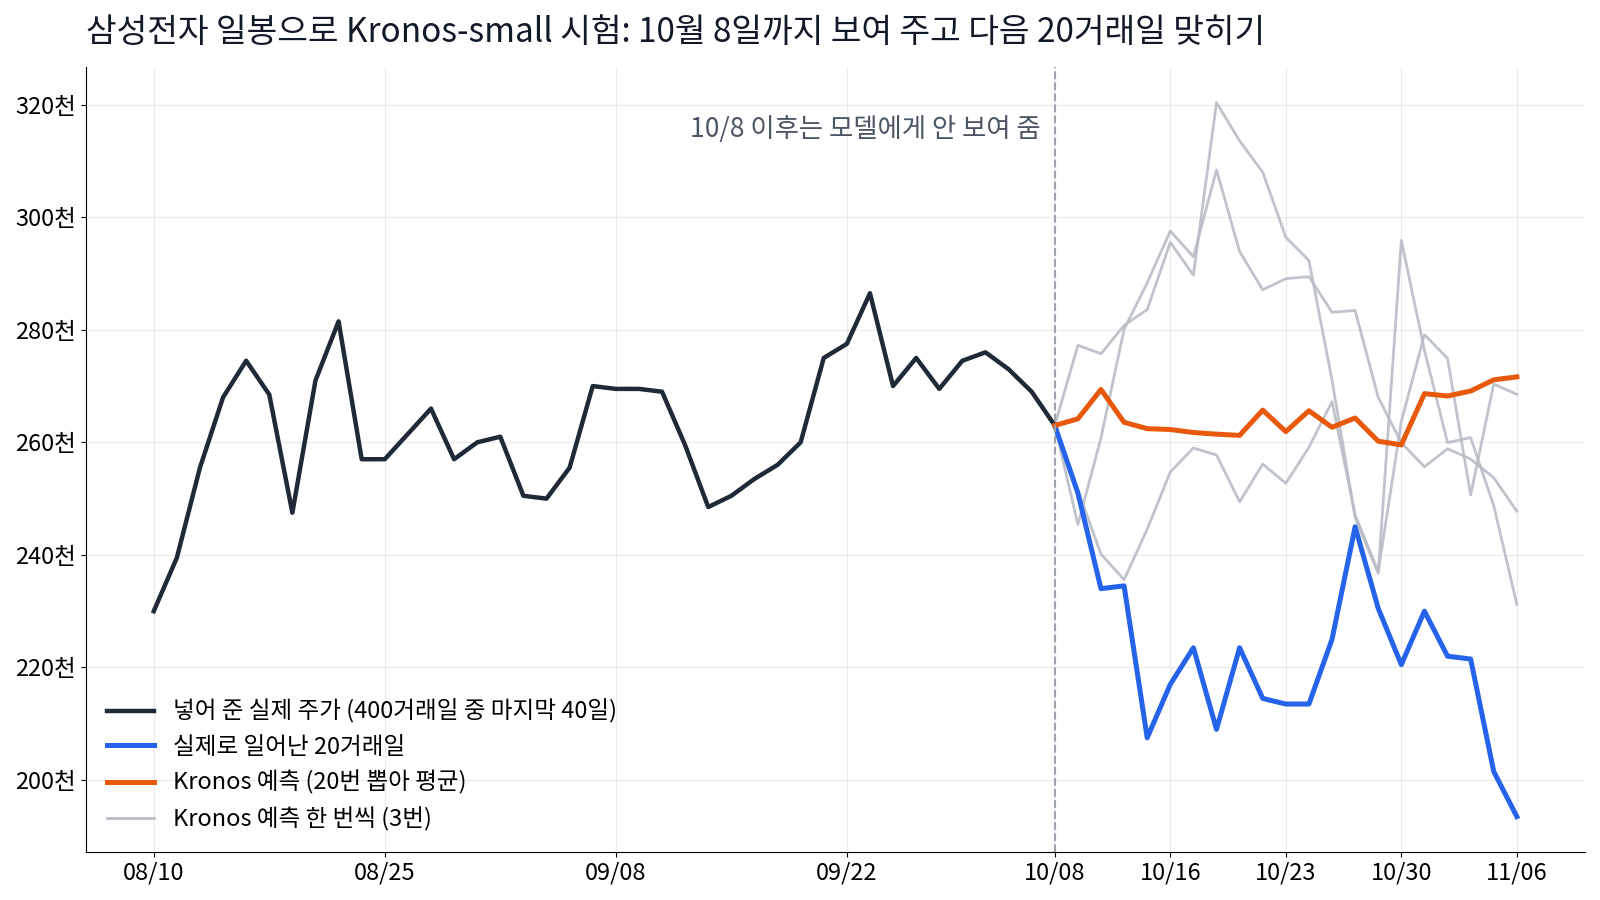
시험 방법은 이렇습니다. 2025년 2월 18일부터 2026년 10월 8일까지 400거래일만 Kronos-small에 보여 주고, 그 뒤 20거래일(10월 12일부터 11월 6일까지)의 종가를 예측하게 했습니다. 모델은 10월 8일 이후 데이터를 전혀 보지 못합니다. 설정은 README 예제와 같은 온도 1.0, top_p 0.9로 두고, 한 번씩 세 번 뽑은 경로와 20번 뽑아 평균 낸 경로를 함께 그렸습니다.
실제 주가는 이 기간에 크게 내렸습니다. 10월 8일 종가 263,000원에서 11월 6일 193,500원으로 26.4% 떨어졌고, 첫날인 10월 12일부터 251,000원으로 내려가 반등 몇 번을 빼면 줄곧 아래쪽이었습니다.
20번 뽑은 예측 평균은 거의 수평선이었습니다. 259,000원대와 271,000원대 사이를 오가다 11월 6일 자리에서 271,633원으로 끝나, 출발점보다 3.3% 높았습니다. 20거래일 동안 예측 평균과 실제 종가의 차이를 비율로 평균 내면 20.0%입니다.
한 번씩 뽑은 경로는 훨씬 들쭉날쭉했습니다. 한 경로는 열흘도 안 돼 320,356원까지 올랐다가 231,217원으로 끝났고, 다른 경로는 235,593원까지 내려갔다가 268,539원으로 돌아왔습니다. 세 경로 모두 실제 종가의 최저치 193,500원에는 닿지 않았습니다.
이 결과가 말해 주는 것은 단순합니다. 여러 경로를 평균 내면 오르는 길과 내리는 길이 서로 상쇄돼 지난 흐름을 이어 가는 평평한 선이 나옵니다. 그리고 차트 바깥에서 들어온 소식이나 수급 변화는 모델이 볼 수 없습니다. 하나의 종목, 한 구간에서 나온 결과라 모델 전체의 실력을 판정할 수는 없지만, 급락 같은 큰 움직임을 미리 알려 주는 도구로 기대하면 안 된다는 점은 분명히 보였습니다.
속도는 CPU 기준으로 경로 하나에 17초에서 19초, 20번 뽑아 평균 내는 데는 433초가 걸렸습니다. 실행 중 메모리는 최대 1GB 정도를 썼습니다. 일봉 한두 종목을 가끔 돌려 보는 정도라면 그래픽카드 없이도 충분하지만, 여러 종목을 여러 번 뽑으려면 시간이 빠르게 늘어납니다.
from model import Kronos, KronosTokenizer, KronosPredictor
import pandas as pd

tokenizer = KronosTokenizer.from_pretrained("NeoQuasar/Kronos-Tokenizer-base")
model = Kronos.from_pretrained("NeoQuasar/Kronos-small")
predictor = KronosPredictor(model, tokenizer, device="cpu", max_context=512)

df = pd.read_csv("data/samsung_005930_daily.csv", parse_dates=["timestamps"])
end = df.index[df["timestamps"] == "2026-10-08"][0]
x = df.loc[end-399:end]
y_time = df.loc[end+1:end+20, "timestamps"].reset_index(drop=True)

pred = predictor.predict(
    df=x[["open", "high", "low", "close", "volume"]].reset_index(drop=True),
    x_timestamp=x["timestamps"].reset_index(drop=True),
    y_timestamp=y_time,
    pred_len=20, T=1.0, top_p=0.9, sample_count=20,
)
print(pred["close"])Kronos 웹 UI 사용법: 버튼 몇 번으로 예측, 그대로 띄우면 안 되는 이유
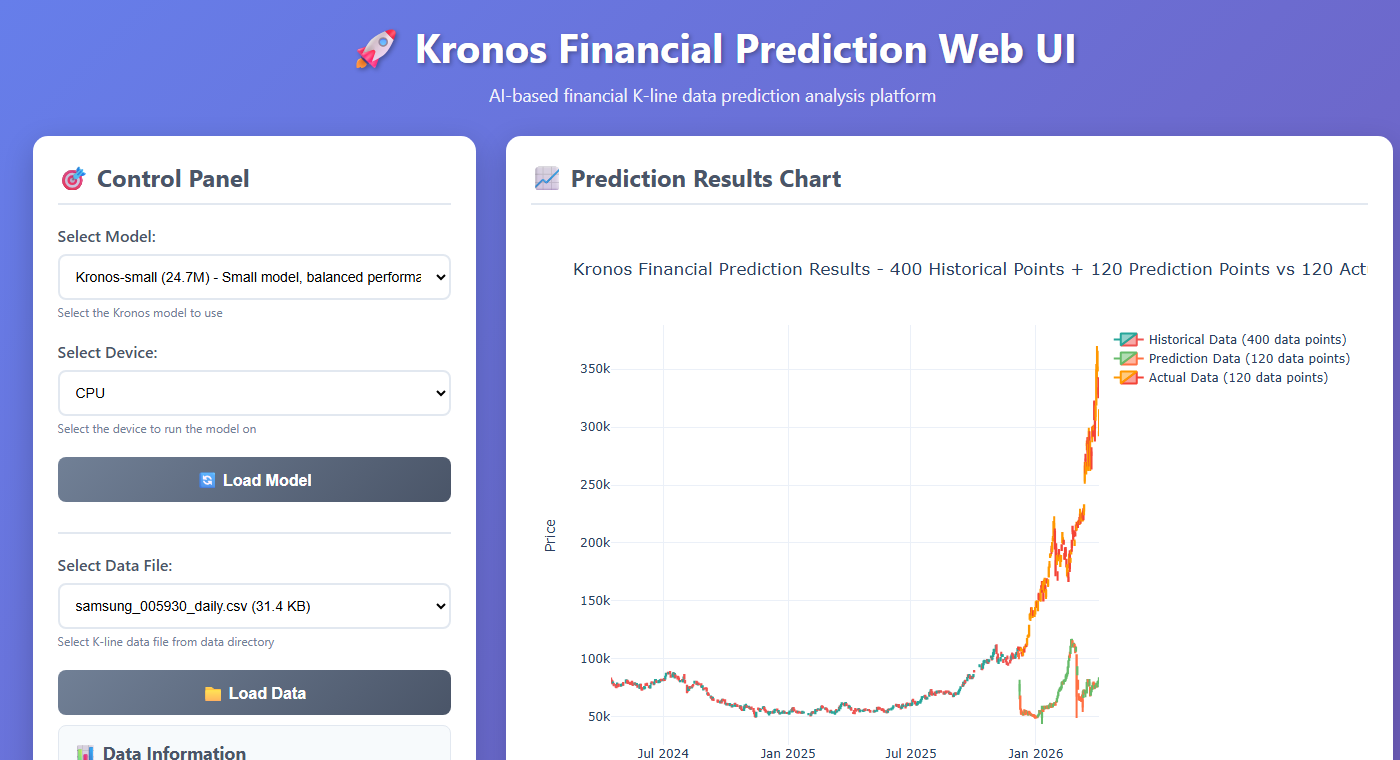
코드를 쓰기 싫다면 저장소의 webui 폴더에 있는 웹 화면을 쓰면 됩니다. webui 폴더에서 python run.py를 실행하고 브라우저에서 localhost:7070을 열면 왼쪽에 모델 선택(mini, small, base), 장치 선택(CPU, CUDA, 애플 실리콘 MPS), data 폴더의 파일 목록이 나옵니다. 모델을 불러오고 데이터를 불러온 뒤 슬라이더로 구간을 고르고 예측 버튼을 누르면 오른쪽에 봉 차트와 오차 표가 그려집니다. 웹 화면용으로 Flask와 plotly가 추가로 필요합니다.
웹 화면은 400개 봉을 보여 주고 다음 120개 봉을 예측하는 구간이 고정이라 시간이 더 걸립니다. CPU에서 120단계를 만드는 데 약 4분, 한 단계에 2초 정도였습니다. 기본 구간으로 돌렸더니 평균 절대 백분율 오차가 61.53%로 나왔습니다. 실제 주가가 가파르게 오른 구간이었는데 예측선은 한참 아래에 머물렀습니다.
써 보면서 눈에 띈 점이 두 가지 있습니다. 하나는 날짜입니다. 일봉 데이터를 넣어도 예측 구간 날짜를 거래일이 아니라 달력 날짜로 이어 붙여서, 비교 표에 2025년 12월 6일 같은 토요일 날짜가 섞여 나왔습니다. 그래프의 가로축을 그대로 믿기보다 몇 번째 봉인지로 보는 편이 맞습니다.
다른 하나는 보안입니다. run.py와 app.py 모두 debug=True, host='0.0.0.0'으로 서버를 띄웁니다. 실행 로그에도 디버그 모드가 켜져 있고 모든 주소에서 접속을 받는다고 나옵니다. 같은 와이파이에 있는 다른 기기에서도 이 화면에 들어올 수 있고, 플라스크 디버그 모드는 외부에 열어 두면 안 되는 기능입니다. 내 PC에서만 쓸 거라면 실행 전에 두 파일의 host 값을 127.0.0.1로, debug를 False로 바꿔 두는 것이 안전합니다.
근거 [1]
공식 데모와 논문 숫자 읽는 법
프로젝트에는 비트코인 가격으로 만든 공식 데모 페이지도 있습니다. 바이낸스의 BTC/USDT 1시간봉 최근 360시간(약 15일)을 Kronos-mini에 넣고, 경로 30개를 뽑아 24시간 뒤 가격이 오를 확률과 변동성이 커질 확률을 보여 주는 구성입니다. 다만 페이지에 적힌 마지막 갱신 시각이 2026년 7월 4일 11시(UTC)라, 지금은 실시간 예측이 아니라 그 시점 화면이 남아 있는 상태입니다.
논문이 내세우는 숫자도 읽는 법이 있습니다. 논문 요약에 따르면 가격 예측의 RankIC가 가장 앞선 범용 시계열 기반 모델보다 93%, 사전 학습을 하지 않은 최고 모델보다 87% 높았고, 변동성 예측 오차(MAE)는 9% 낮았으며, 가짜 봉 데이터를 만드는 품질은 22% 좋아졌습니다.
여기서 RankIC는 여러 종목의 예상 수익률 순위가 실제 순위와 얼마나 비슷한지를 재는 값입니다. 한 종목의 가격을 원 단위로 맞혔다는 뜻이 아니고, 이 수치만으로 수익이 난다는 뜻도 아닙니다. 위 삼성전자 시험처럼 종목 하나의 다음 한 달을 맞히는 쓰임과는 결이 다릅니다.
저장소에는 중국 A주 데이터로 모델을 미세 조정하고 간단한 백테스트까지 돌리는 예제도 있습니다. README는 이 과정이 미세 조정 방법을 보여 주는 예시일 뿐이고 실제 운용용 퀀트 시스템이 아니라고 적고 있습니다. 미세 조정 스크립트는 여러 개의 그래픽카드를 쓰는 torchrun 기준이라 CPU만 있는 PC에서 따라 하기는 어렵습니다.
Kronos가 쓸 만한 곳과 비슷한 도구와의 차이
구글 TimesFM이나 아마존 Chronos 같은 범용 시계열 기반 모델은 날씨, 전력 사용량, 매출처럼 어떤 숫자 흐름이든 받아서 다음 값을 예측합니다. Kronos는 대상을 금융 봉 데이터로 좁히고, 가격 네 개와 거래량을 함께 하나의 기호로 묶어 배운 것이 다릅니다. 논문은 기존 범용 모델이 봉 데이터에서는 오히려 사전 학습하지 않은 모델보다 못한 경우가 많았다는 점을 출발점으로 삼았습니다.
써 보고 나니 쓸 곳은 꽤 분명합니다. 경로를 수십 개 뽑아 앞으로 가격이 얼마나 넓게 흔들릴 수 있는지 그려 보는 일, 전략을 시험할 가짜 봉 데이터를 만드는 일, 내가 만든 예측 모델과 비교할 기준선으로 두는 일, 그리고 금융 시계열과 트랜스포머가 어떻게 만나는지 공부하는 용도입니다. 설치가 쉽고 CPU로도 돌아가서 주말 동안 만져 보기에 부담이 없습니다.
반대로 종목 하나를 골라 다음 주에 오를지 내릴지 정하는 데 쓰기에는 맞지 않습니다. 위 결과처럼 평균은 평평해지고, 한 번씩 뽑은 경로는 오르기도 내리기도 하며, 실적 발표나 뉴스처럼 차트에 없는 정보는 반영되지 않습니다. 이 글은 특정 종목의 매수나 매도를 권하는 글이 아니며, 투자 판단과 그 책임은 본인에게 있습니다.