대화가 길어질 때 진짜 아까운 것은 사용량
AI 코딩 에이전트와 한 세션에서 오래 일하면 대화가 수십만 토큰까지 쌓입니다. 보통은 느려질까 봐 걱정하는데, 실제로 재 보면 속도는 생각보다 덜 떨어집니다. pi에서 Claude로 짧은 답을 받는 시간을 비교해 보니, 프롬프트 캐시가 살아 있을 때 대화가 6만 5천 토큰이면 1.5초, 80만 토큰이면 2초에서 4.8초 사이였습니다.
문제는 사용량입니다. 모델은 요청할 때마다 쌓인 대화 전체를 다시 읽습니다. 캐시 덕분에 싸게 읽긴 하지만, 대화가 커질수록 매번 읽는 양도 같이 커집니다. 최근 7일 동안 pi에서 Claude를 7,711번 호출한 기록을 API 요금 비율로 나눠 보면 쌓인 대화를 다시 읽는 데 73%, 캐시를 새로 쓰는 데 17%, 실제 답변을 쓰는 데 11%가 들었습니다. 답을 만드는 것보다 이미 했던 이야기를 다시 읽는 데 훨씬 많이 쓰고 있었던 셈입니다.
캐시가 끊기는 순간도 비쌉니다. Claude의 프롬프트 캐시는 기본 수명이 5분이라, 잠깐 자리를 비웠다 돌아오면 큰 대화를 통째로 다시 캐시에 써야 합니다. 같은 일주일 동안 이런 일이 65번 있었고, 전체 비용의 약 10%가 여기서 나갔습니다. 대화를 작게 유지할수록 다시 읽는 양도, 캐시를 새로 쓰는 양도 같이 줄어듭니다.
| 어디에 썼나 | 비율(API 요금 기준) |
|---|---|
| 쌓인 대화를 다시 읽기(캐시 읽기) | 73% |
| 캐시를 새로 쓰기 | 17% |
| 답변 출력 | 11% |
최근 7일 pi의 Claude 요청 7,711번을 API 요금 비율로 나눈 값. 반올림 때문에 합이 100%를 조금 넘는다.
근거 [10]
압축하고 새 세션을 열면 흐려지는 것
그래서 대화를 줄이는 방법은 두 가지로 모입니다. 하나는 압축입니다. Claude Code, Codex, pi 모두 대화가 한도에 가까워지면 앞부분을 요약으로 바꾸고 최근 대화만 원문으로 남깁니다. 다른 하나는 작업이 바뀔 때 새 세션을 여는 것입니다. 둘 다 다시 읽는 양을 크게 줄여 주는데, 그만큼 앞에서 오간 내용이 빠집니다.
압축하면 대화로만 했던 지시, 정확한 오류 문구, 그 방법을 고른 이유 같은 세부가 요약 속에서 흐려집니다. 대화 초반에 '이 파일은 건드리지 마'나 '배포는 develop 브랜치에만' 같은 말을 한 번 했다면, 압축 뒤에는 AI가 그 말을 놓치기 쉽습니다. 새 세션은 더 분명해서, 지난 대화를 아예 볼 수 없습니다. 같은 설명을 처음부터 다시 하게 되는 이유가 여기에 있습니다.
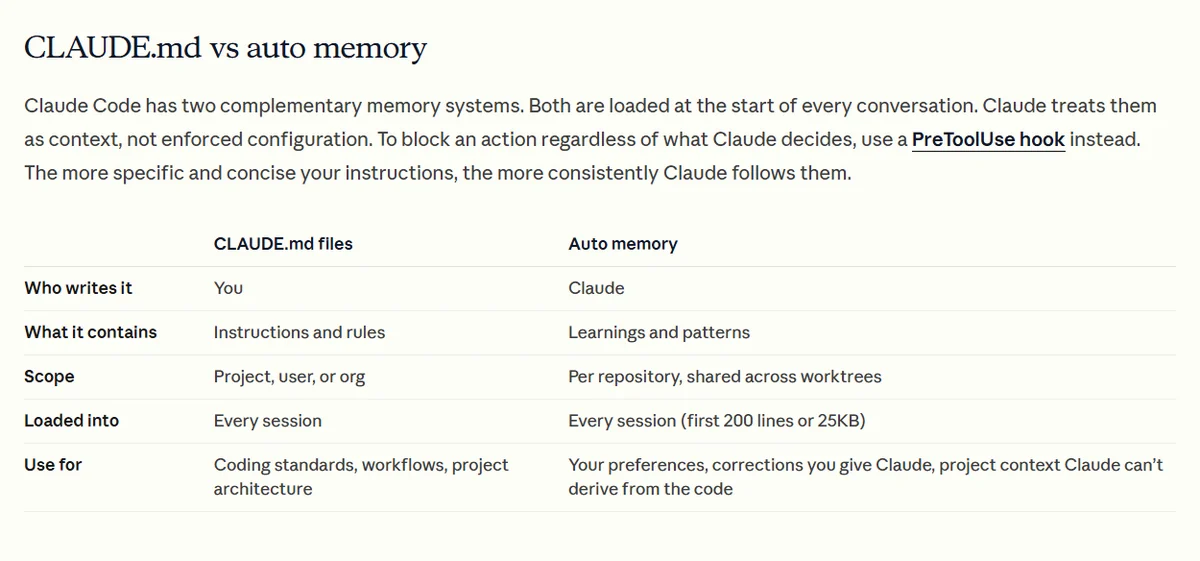
도구에 들어 있는 기억 기능도 이 빈자리를 다 채우지는 못합니다. Claude Code에는 Claude가 스스로 적는 자동 메모가 있지만, 새 세션을 시작할 때 그 메모를 앞 200줄 또는 25KB까지만 불러옵니다. Codex의 로컬 기억 기능은 기본으로 꺼져 있고, 켜더라도 대화가 기본 6시간 이상 쉬어야 기억으로 정리됩니다. 두 기능 모두 각자의 도구 안에만 남기 때문에, Claude Code에서 정한 내용을 Codex가 알 방법도 없습니다.
Memnest가 하는 일: 대화 원문을 저장하고 필요할 때 찾기
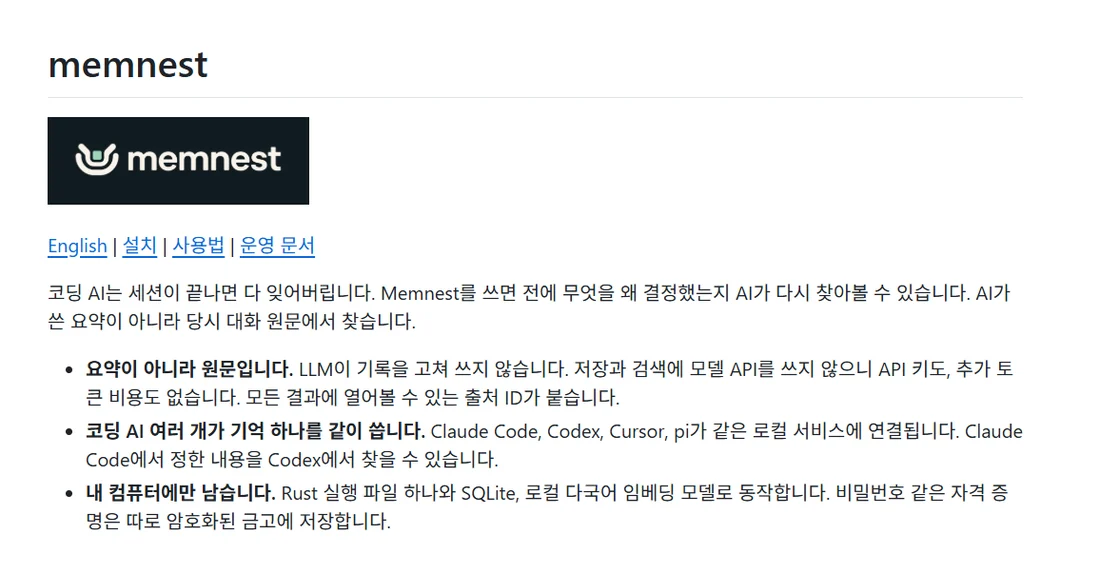
Memnest는 이 빈자리를 채우려고 만든 오픈소스 기억 저장소입니다. 코딩 AI와 나눈 대화를 요약하지 않고 원문 그대로 내 컴퓨터의 SQLite에 저장해 두고, 나중에 AI가 검색해서 그 원문을 다시 읽게 합니다. 압축으로 흐려진 지시나 지난 세션에서 정한 결정을 AI가 직접 찾아볼 수 있게 되는 것입니다.
저장과 검색에 생성형 모델을 쓰지 않는다는 점이 다른 기억 도구와 가장 크게 다릅니다. 검색은 BM25 키워드 검색과 로컬 다국어 임베딩으로 처리하기 때문에 API 키도, 추가 토큰 비용도 들지 않습니다. 검색 결과마다 출처 ID가 붙어서 AI가 어떤 기록을 근거로 답했는지 바로 열어 볼 수 있습니다. AI가 만든 요약을 또 요약하는 구조가 아니라 원문을 찾아 읽는 구조라서, 오래 써도 기록이 바뀌지 않습니다.
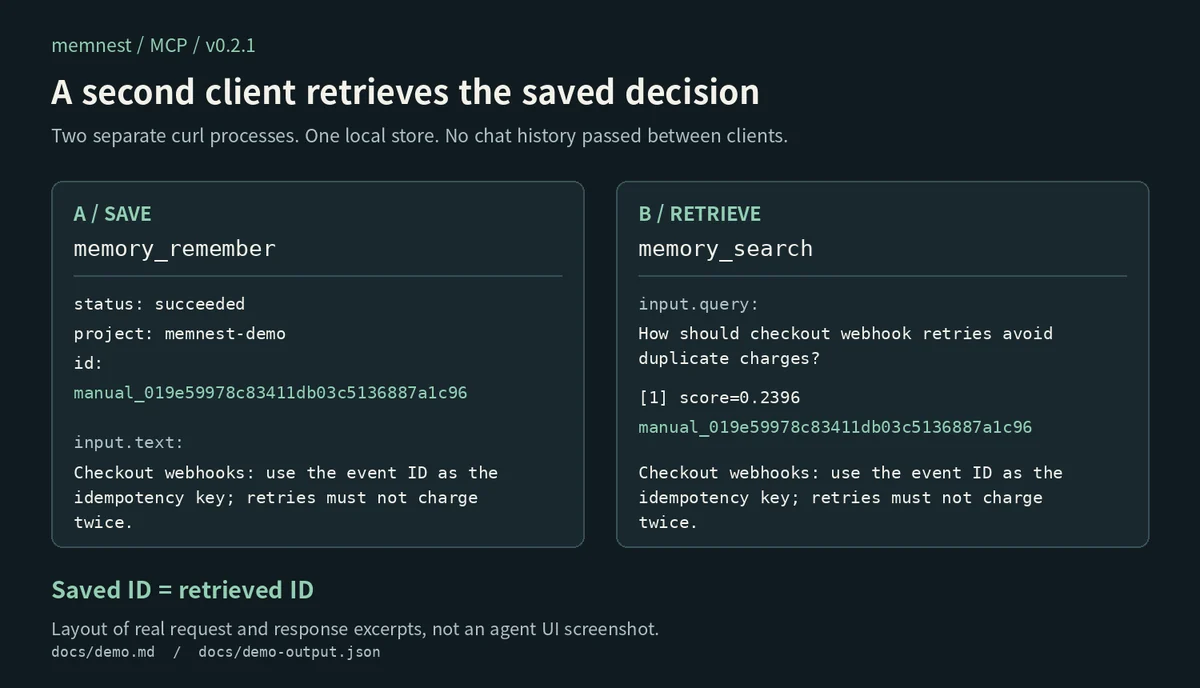
Claude Code, Codex, Cursor, pi가 같은 로컬 서비스에 붙는다는 점도 큽니다. Claude Code에서 정한 배포 방식을 Codex에서 물어봐도 같은 기록이 나옵니다. memnest watch가 Claude Code, pi, Codex의 대화 기록 파일을 따라가며 화면에 보인 대화를 저장하기 때문에, 따로 저장하라고 시키지 않아도 대화가 쌓입니다. 꼭 남겨야 하는 결정은 memory_remember로 직접 저장하고, 사실이 바뀌면 supersedes로 예전 기록을 새 기록으로 대체합니다.
Memnest를 붙이면 압축을 일찍 해도 부담이 적다
Memnest를 붙여 두면 대화를 작게 유지하는 방법을 마음 놓고 쓸 수 있습니다. 압축이나 새 세션의 단점은 앞의 내용이 흐려진다는 것인데, 원문이 Memnest에 남아 있으니 필요할 때 다시 찾으면 되기 때문입니다. 대화 길이를 아끼는 일과 지난 맥락을 지키는 일을 따로 할 수 있게 되는 셈입니다.
pi에서는 압축 시점을 설정 파일에서 정합니다. ~/.pi/agent/settings.json의 compaction 항목에서 reserveTokens는 남은 자리가 이 값보다 작아지면 압축을 시작하는 기준이고, keepRecentTokens는 요약하지 않고 원문으로 남길 최근 대화의 양입니다. 압축은 대화 토큰이 컨텍스트 크기에서 reserveTokens를 뺀 값을 넘을 때 시작되므로, reserveTokens를 크게 잡을수록 일찍 압축됩니다. 모델마다 다르게 하려면 modelOverrides에 provider/모델ID를 키로 넣습니다.
Claude Opus를 쓰는 pi에서 60만 토큰쯤에 압축되던 것을 30만 토큰 근처에서 압축되도록 바꿔 돌려 봤습니다. 35만 토큰에서 압축이 일어났고 요약에 15초가 걸렸으며, 대화는 12만 7천 토큰으로 줄었습니다. 다음 요청부터는 캐시도 정상으로 다시 동작했습니다. 압축 한 번에 드는 비용은 대략 20턴이면 줄어든 읽기 양으로 돌려받았고, 지난 7일 기록에 대입하면 25만 토큰에서 압축하고 최근 6만 토큰만 남길 때 전체 사용량이 약 20% 줄어드는 것으로 계산됐습니다.
효과가 가장 컸던 건 설정보다 습관이었습니다. 작업 주제가 바뀌면 지금까지 정한 것을 Memnest에 저장하고 새 세션을 엽니다. 새 세션에서 '지난번에 정한 배포 방식 찾아 줘'처럼 물으면 AI가 memory_search로 원문을 찾아 이어 갑니다. 대화는 작게 유지되고 지난 결정은 그대로 남습니다.
{
  "compaction": {
    "enabled": true,
    "reserveTokens": 30000,
    "keepRecentTokens": 60000,
    "modelOverrides": {
      "anthropic/claude-opus-5-5": { "reserveTokens": 700000 }
    }
  }
}Memnest 설치하고 pi, Claude Code, Codex에 연결하는 방법
설치는 명령 한 줄입니다. 설치 스크립트가 최신 릴리스를 사용자 계정에 받고 서버와 대화 감시기를 시작한 뒤, 컴퓨터에서 찾은 Claude Code, Codex, Cursor 설정에 Memnest를 추가합니다. 기존 설정은 먼저 백업하고, 되돌리는 명령도 함께 출력해 줍니다. 스크립트를 먼저 읽어 보고 싶거나 버전을 고정하고 싶다면 파일로 받은 뒤 VERSION을 지정해 실행하면 됩니다.
지원 환경은 Apple Silicon 맥, systemd가 있는 리눅스 x86_64(glibc 2.35 이상, 우분투 22.04나 데비안 12 등), 리눅스 Arm64(glibc 2.39 이상, 우분투 24.04 등)입니다. 설치 과정에 파이썬 3이 필요합니다. 처음 저장하거나 검색할 때 약 1.1GB짜리 임베딩 모델을 내려받고, 임베딩 중에는 메모리를 1.9GB쯤 씁니다. 인텔 맥은 소스에서 빌드해야 하고, 윈도우에서는 systemd를 켠 WSL 우분투에 설치해 쓰면 됩니다.
pi는 확장을 따로 설치합니다. 코어가 돌고 있는 상태에서 pi install npm:pi-memnest@0.4.0을 실행하고, pi 안에서 /memnest를 입력하면 서비스 상태와 저장된 기억 수, 데이터 폴더가 나옵니다. 그 밖의 MCP 클라이언트는 http://127.0.0.1:3111/mcp 주소로 연결합니다. 설치하기 전에 나눈 대화는 자동으로 다 가져오지 않으니, 남겨 두고 싶은 대화 파일만 골라 가져오는 기능을 쓰면 됩니다.
# 1. 코어 설치 (서버와 대화 감시기 시작, Claude Code/Codex/Cursor 설정 추가)
curl -fsSL https://raw.githubusercontent.com/Blue-B/memnest/main/core/scripts/install.sh | bash

# 스크립트를 먼저 읽고 버전을 고정해 설치할 때
curl -fsSL https://raw.githubusercontent.com/Blue-B/memnest/main/core/scripts/install.sh -o /tmp/memnest-install.sh
less /tmp/memnest-install.sh
VERSION=v0.4.3 bash /tmp/memnest-install.sh --user

# 2. pi 연결
pi install npm:pi-memnest@0.4.0
# pi 안에서 연결 확인
/memnestMemnest를 오래 잘 쓰는 습관
매번 꼭 지켜야 하는 규칙 몇 개는 AGENTS.md나 CLAUDE.md에 두는 편이 간단합니다. Memnest는 계속 늘어나는 대화와 결정을 필요할 때 찾아보는 용도입니다. 둘을 나눠 쓰면 매 요청에 붙는 내용은 짧게 유지하면서도, 몇 주 전에 정한 결정까지 놓치지 않을 수 있습니다.
자동으로 기억을 끼워 넣는 기능은 기본으로 꺼져 있어서, 처음에는 필요할 때 '지난번 결정 찾아 줘'처럼 직접 요청하는 방식으로 시작합니다. 매 질문마다 관련 기억을 카드로 붙이고 싶다면 MEMNEST_AUTOCONTEXT_MODE=balanced를 설정하고 pi를 시작하면 됩니다. 한 카드에 결과 2개, 한 세션에 카드 4장이 기본 한도라서 대화가 크게 불어나지 않습니다.
저장된 기억은 그때의 기록이라, 오래된 결정을 쓸 때는 출처 ID로 원문을 열어 지금도 맞는지 보고 쓰는 습관을 들이면 좋습니다. 바뀐 사실은 새 기록으로 저장하면서 예전 기록을 대체하면 검색에도 새 내용이 먼저 나옵니다. 일반 기억은 암호화되지 않으니 3111 포트는 인터넷에 열지 말고, 비밀번호 같은 값은 따로 암호화되는 금고 도구에 넣습니다.