한국어 토큰이 왜 화제가 됐나
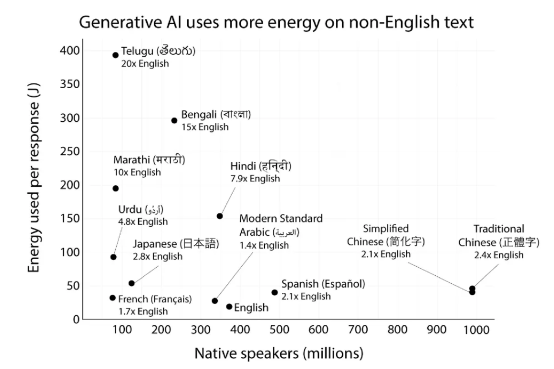
11월 초 미시간대 연구진이 생성형 AI가 영어가 아닌 언어를 처리할 때 에너지를 더 쓴다는 연구를 내놨고, 이 소식이 이번 주 해커뉴스 첫 화면까지 올라왔습니다. 연구 요지는 단순합니다. 같은 질문에 답해도 언어에 따라 모델이 만들어 내는 토큰 수가 다르고, 토큰이 많을수록 전기도 더 든다는 것입니다.
연구진은 큐원3, 젬마3, 라마3.1 세 가지 공개 모델에 122개 언어로 된 독해 문제 모음인 Belebele를 풀게 하고, 응답 하나에 든 에너지를 쟀습니다. 영어 대비 1.4배에서 많게는 180배까지 차이가 났고, 서유럽 언어는 대부분 2배 이하였지만 힌디어는 7.9배, 벵골어는 15.3배였습니다. 이 결과는 EMNLP 2026 학회 논문으로 나왔습니다.
보도자료 그래프에는 한국어가 없습니다. 대신 연구진이 공개한 언어별 데이터 표에 한국어 줄이 있습니다. 한국어 응답 하나에 든 에너지는 평균 59.6J로 영어 19.5J의 약 3.05배였습니다. 일본어는 2.78배, 간체 중국어는 2.10배, 스페인어는 2.08배였으니 한국어는 꽤 무거운 편에 속합니다.
연구진은 이 차이를 이중 부담이라고 부릅니다. 영어가 아닌 언어를 쓰는 사람은 같은 일을 시키고도 돈을 더 내거나, 모국어가 아닌 언어로 바꿔 물어야 한다는 것입니다. 인구 자료와 맞춰 보면 지금 약 52억 명이 모국어로 글을 만들 때 영어 사용자의 두 배가 넘는 에너지를 쓴다는 계산도 내놨습니다.
토큰이 뭐고 한국어는 왜 더 잘게 잘리나
AI 모델은 글자를 그대로 읽지 않습니다. 먼저 글을 토큰이라는 조각으로 자르고, 조각마다 번호를 붙여 계산합니다. 자주 나오는 영어 단어는 통째로 한 조각이 되는 경우가 많습니다. OpenAI 토크나이저 페이지도 흔한 영어 글은 토큰 하나가 대략 4글자라고 안내합니다.
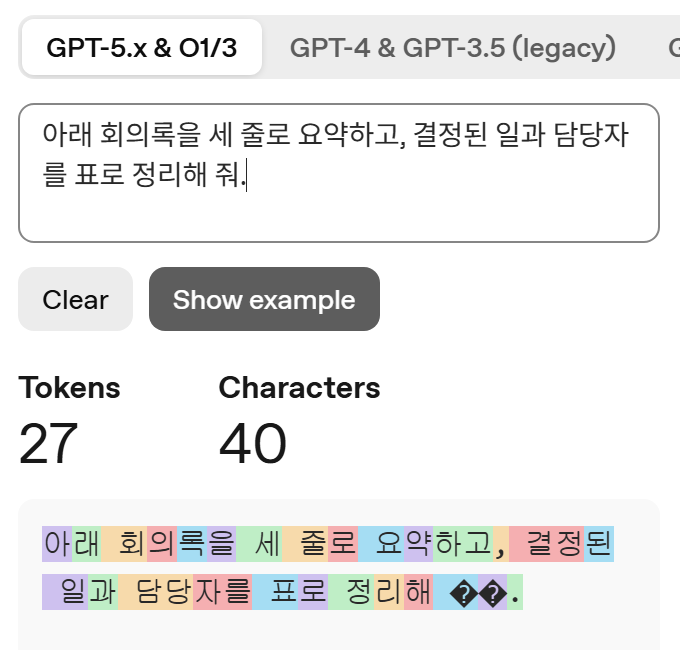
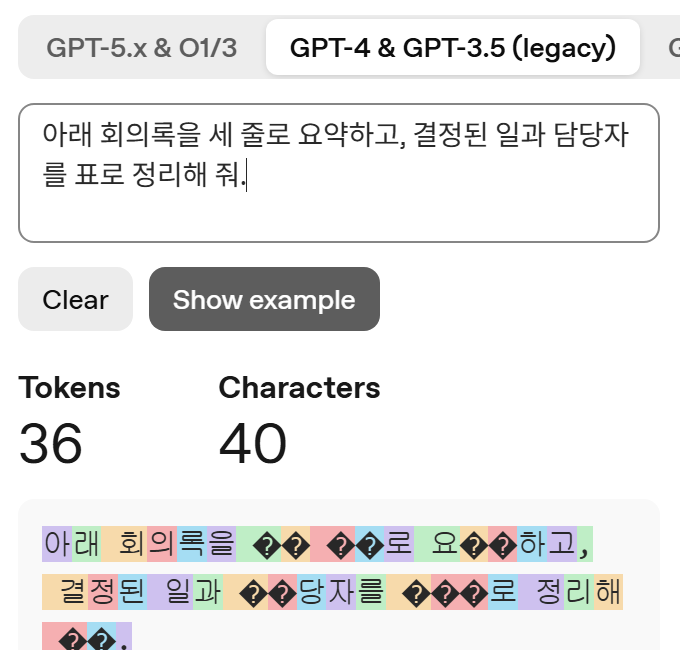
한국어는 사정이 다릅니다. 토크나이저 어휘를 만들 때 쓴 학습 글에서 한국어 비중이 영어보다 훨씬 작으니, 한국어 낱말은 통째로 어휘에 들어가지 못하고 음절이나 그보다 작은 바이트 단위로 쪼개지는 일이 잦습니다. 실제로 '회의록을 세 줄로 요약해 줘'를 넣어 보면 '요약'이 '요'와 '약' 두 조각으로 갈리고, 마지막 '줘'는 글자 하나가 깨진 두 조각으로 나옵니다.
연구진 설명도 같은 방향입니다. 토큰이 많으면 메모리를 더 차지하고, 메모리가 빠듯하면 한 번에 묶어 처리하는 양이 줄어 토큰 하나당 에너지도 늘어납니다. 그리고 AI 회사들은 대개 토큰 수로 요금을 받으니 토큰이 많으면 돈도 더 듭니다.
문자가 복잡할수록 더 심해집니다. 힌디어 등이 쓰는 데바나가리 문자와 벵골 문자는 기본 글자가 모양을 바꾸고 기호와 결합하면서 만들어지는 글자가 수백만 가지까지 늘어난다고 연구진은 설명합니다. 그래프에서 인도계 언어가 맨 위에 몰린 이유입니다. 한국어는 그 정도까지는 아니어도 낱말이 여러 조각으로 나뉩니다. 최신 토크나이저에서 '회의록을'이라는 낱말은 '회의', '록', '을' 세 조각이 됐습니다.
OpenAI 토크나이저로 한국어 토큰 계산하는 법
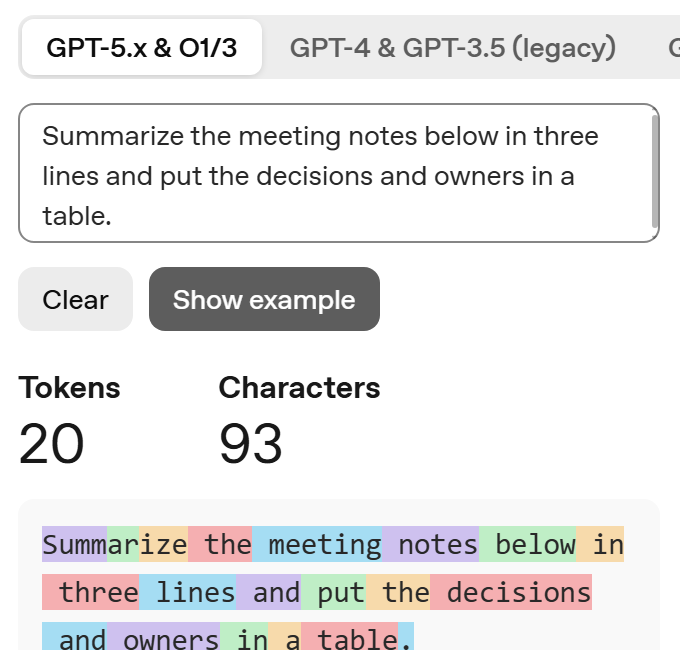
가장 쉬운 한국어 토큰 계산기는 OpenAI가 공개한 토크나이저 페이지입니다. 로그인 없이 열리고, 위쪽 탭에서 GPT-5.x & O1/3, GPT-4 & GPT-3.5(legacy), GPT-3(legacy) 중 하나를 고른 뒤 아래 칸에 글을 붙여 넣으면 Tokens와 Characters 숫자가 바로 나옵니다. 그 아래에는 글이 어떤 조각으로 잘렸는지 색으로 나눠 보여 줍니다.
같은 요청을 영어로 바꿔 'Summarize the meeting notes below in three lines and put the decisions and owners in a table.'를 넣으면 93글자에 토큰 20개입니다. 한국어는 40글자에 27개였으니 글자 수는 절반도 안 되는데 토큰은 1.35배입니다. 한국어 한 글자가 영어 한 글자보다 정보를 많이 담는 대신, 토큰으로는 그만큼 덜 압축된다는 뜻입니다.
탭을 GPT-4 & GPT-3.5(legacy)로 바꾸면 같은 한국어 문장이 36개로 늘어납니다. 영어 문장은 이 탭에서도 20개라 차이가 1.8배까지 벌어집니다. 예전 모델을 쓰던 시절 한국어가 영어보다 두 배쯤 든다는 말이 돌았던 이유가 여기 있고, 최신 토크나이저에서는 그 차이가 꽤 줄었습니다.
근거 [3]
영어 한국어 토큰 차이, 문장 세 쌍으로 재 본 결과
문장 하나로는 우연일 수 있어서, 일상에서 자주 쓰는 글 세 가지를 한국어와 영어로 같은 뜻이 되게 써서 한꺼번에 셌습니다. 회의 일정을 옮기자는 짧은 메일, 회의록 요약 요청, 생활비 줄이는 법을 설명하는 세 문장짜리 문단입니다. 토크나이저는 세 가지를 썼습니다. OpenAI 페이지의 최신 탭과 같은 숫자가 나오는 o200k_base, 옛 GPT-4 탭과 같은 cl100k_base, 그리고 연구에 쓰인 모델 중 하나인 큐원3의 공개 토크나이저입니다.
세는 데 필요한 것은 Node.js와 패키지 두 개뿐입니다. 윈도우 서버에서 gpt-tokenizer와 허깅페이스의 Tokenizers.js를 설치하는 데 37초가 걸렸고, 큐원3 토크나이저 파일은 허깅페이스 Qwen3-8B 저장소에서 약 11MB짜리 tokenizer.json을 받아 불러왔습니다. GPU도, 모델 가중치도, API 키도 필요 없습니다. 세 쌍을 세 가지 방식으로 모두 세는 데 9초가 안 걸렸습니다.
합계로 보면 한국어 250글자는 o200k_base에서 152개, 큐원3에서 182개, cl100k_base에서 239개 토큰이었습니다. 같은 뜻의 영어 579글자는 세 토크나이저 모두 123~125개였습니다. 한국어가 영어보다 1.24배, 1.46배, 1.93배 많은 셈입니다. 한국어 한 토큰에 들어가는 글자는 최신 토크나이저에서 1.64글자, 옛 토크나이저에서는 1.05글자로 거의 한 글자에 한 토큰이었습니다.
문장마다 들쭉날쭉하기도 했습니다. 시간과 요일이 섞인 메일은 옛 토크나이저에서 2.07배까지 벌어졌고, 최신 토크나이저에서는 1.21~1.35배 사이에 모였습니다. 큐원3는 그 중간쯤이었습니다. 어느 모델을 쓰느냐에 따라 같은 한국어 글이 1.2배짜리가 되기도 하고 2배짜리가 되기도 한다는 얘기입니다.
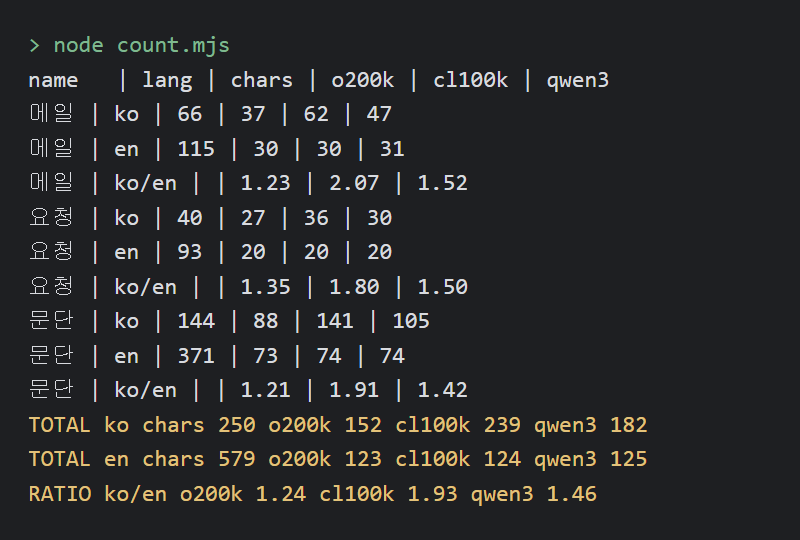
| 글 | o200k_base | 큐원3 | cl100k_base |
|---|---|---|---|
| 짧은 메일 (한 / 영) | 37 / 30 | 47 / 31 | 62 / 30 |
| 요약 요청 (한 / 영) | 27 / 20 | 30 / 20 | 36 / 20 |
| 생활비 문단 (한 / 영) | 88 / 73 | 105 / 74 | 141 / 74 |
| 합계 배수 (한 ÷ 영) | 1.24배 | 1.46배 | 1.93배 |
같은 뜻의 한국어와 영어 문장을 세 토크나이저로 센 토큰 수.
// npm i gpt-tokenizer
import { encode } from 'gpt-tokenizer/encoding/o200k_base';

const ko = '아래 회의록을 세 줄로 요약하고, 결정된 일과 담당자를 표로 정리해 줘.';
const en = 'Summarize the meeting notes below in three lines and put the decisions and owners in a table.';
console.log(encode(ko).length, encode(en).length); // 27 20토큰 1.5배인데 에너지는 3배인 이유
여기서 숫자 하나가 걸립니다. 입력 문장의 토큰 차이는 큐원3 기준 1.46배였는데, 연구 자료의 한국어 응답 에너지는 3.05배입니다. 연구진 데이터 표를 보면 토큰 하나당 에너지는 한국어 0.1146J, 영어 0.1049J로 9% 남짓 차이밖에 나지 않습니다. 그러니 나머지 차이 대부분은 응답 하나를 만드는 데 쓰인 토큰 수에서 나온다고 봐야 합니다.
연구는 질문을 읽는 데서 끝나지 않고 모델이 답을 만들어 내는 과정까지 쟀습니다. 답을 만드는 동안 나오는 토큰마다 계산이 한 번씩 돌기 때문에, 응답 하나로 보면 입력 문장에서 본 차이보다 더 벌어질 수 있습니다. 다만 이 수치는 세 공개 모델과 연구진이 고른 문제로 잰 평균이라, ChatGPT나 클로드 같은 서비스에서 한국어 질문이 꼭 3배 비싸다는 뜻은 아닙니다.
연구진은 해결책으로 언어별로 다듬은 모델에 질문을 보내는 방식, 번역이 믿을 만하면 질문을 영어로 옮겨 큰 모델에 넣는 방식, 원어민 참여로 학습 자료를 늘리는 방식을 제안했습니다. 정확도 얘기도 함께 나옵니다. 에너지를 많이 쓰는 언어일수록 답의 정확도도 낮은 경향이 있었다는 것이 제1저자의 설명입니다.
AI 쓸 때 한국어 토큰 아끼는 방법
일반 구독으로 채팅만 한다면 토큰 수를 하나하나 셀 필요는 없습니다. 신경 쓸 곳은 같은 글을 계속 붙이는 경우입니다. 프로젝트 지침, 맞춤 지시, 매번 앞에 붙이는 긴 프롬프트처럼 대화마다 다시 들어가는 글은 한 번 토크나이저 페이지에 넣어 숫자를 보고, 겹치는 말과 인사말을 걷어 내는 것만으로도 꽤 줄어듭니다.
API로 쓰는 경우는 돈과 바로 연결됩니다. 요금이 입력과 출력 토큰 수로 매겨지니, 같은 일을 시켜도 한국어 지시문과 한국어 답변은 영어보다 몇 할씩 더 나옵니다. 고정 지시문만 영어로 쓰고 답은 한국어로 받는 방법도 있는데, 이번 측정 기준으로 최신 토크나이저에서는 줄어드는 폭이 20% 안팎이라 지시문 품질이 떨어질 정도로 무리해서 바꿀 일은 아닙니다. 옛 모델을 계속 쓰고 있다면 한국어가 두 배 가까이 들어가니 모델을 바꾸는 쪽이 먼저입니다.
답변 길이도 같이 봐야 합니다. 응답 에너지 차이 대부분이 출력 토큰에서 나온다면, '세 줄로', '표 하나로'처럼 답의 길이와 모양을 정해 주는 한 줄이 토크나이저를 고르는 것보다 효과가 큽니다. 위에서 쓴 요약 요청도 그런 이유로 줄 수를 정해 둔 문장입니다.