테스트를 통과한 코드와 병합할 코드의 차이
코딩 AI가 수정한 파일을 받고 테스트도 통과했는데, 막상 코드를 읽어보면 그대로 합치기 어려울 때가 있습니다. 눈앞의 오류는 사라졌어도 비슷한 경로에 같은 버그가 남거나, 공개 함수가 없어지거나, 필요하지 않은 파일까지 바뀌는 식입니다. FrontierCode 2.0은 이 간격을 평가 대상으로 삼습니다. Devin을 만드는 Cognition이 10월 27일 발표했으며, 단순히 지시한 기능이 동작하는지를 넘어 저장소 관리자가 실제로 받아들일 변경인지를 묻습니다.
여기서 병합 가능성은 보기 좋은 코드라는 인상만을 뜻하지 않습니다. 기능의 정확성, 테스트 품질, 변경 범위, 기존 스타일과 코드베이스 규칙을 함께 평가합니다. 이미 있는 추상화를 재사용해야 하는지, 사용자가 말하지 않은 입력 형식도 지원해야 하는지처럼 실제 개발에서 자주 생기는 판단이 포함됩니다. 따라서 이 점수는 한 번의 답변으로 알고리즘 문제를 맞히는 능력과는 다른 면을 보여줍니다.
순위표를 볼 때는 무엇을 측정했는지부터 구분하는 편이 좋습니다. 이 벤치마크에서 45.5%를 받았다고 모든 개발 업무의 성공 확률이 45.5%라는 뜻은 아닙니다. 정해진 과제와 채점 기준, 실행 도구 아래에서 계산한 점수입니다. 개인 프로젝트의 짧은 수정과 여러 사람이 관리하는 라이브러리의 변경은 요구되는 품질과 위험이 다르기 때문에 같은 숫자로 결과를 예측할 수는 없습니다.
Introducing FrontierCode 2.0: our new coding benchmark that measures a model’s ability to go beyond the spec. Most coding evals measure a model’s ability to write code that meets a spec. With FrontierCode 1.0, we asked a new question: would you actually merge the PR? https://t.co/EnpK2Udp7U
— Cognition (@cognition) 2026년 10월 28일
132개 과제와 하나라도 놓치면 0점인 필수 조건
FrontierCode 2.0은 실제 오픈소스 저장소를 바탕으로 만든 132개 과제로 구성됩니다. Cognition에 따르면 20명이 넘는 오픈소스 개발자가 자신이 관리하는 저장소에서 과제를 만들었으며, 과제 하나에 40시간 이상을 들였습니다. 단위 테스트뿐 아니라 평가 항목과 별도의 검사기를 함께 사용하고, 연구자의 검토와 여러 단계의 품질 관리를 거칩니다. 제공자의 설명이라는 점은 유지해서 읽어야 합니다.
점수는 평가 항목을 가중 합산한 값입니다. 다만 필수 조건인 blocking criteria를 통과하지 못한 해답은 0점을 받습니다. 기능 대부분이 맞아도 호환성을 깨거나 중요한 자원 정리를 빠뜨리면 다른 부분의 점수로 상쇄하지 못할 수 있습니다. 순위표의 Score와 Pass rate가 별도 열로 표시되는 이유도 여기에 있습니다. 가중 점수와 실행 통과율은 같은 수치가 아니므로 서로 바꿔 읽으면 안 됩니다.
이전 1.1과 비교하면 과제에 쓰인 저장소 수가 55% 늘고 필수 조건 수는 43% 늘었습니다. 기준 해답이 고치는 파일은 평균 67%, 코드 줄은 89% 많아졌고 코드베이스 크기도 25% 커졌습니다. 문제의 구성과 난도가 달라졌으므로 이전 버전보다 점수가 낮아졌다는 이유만으로 모델 자체가 퇴보했다고 해석할 수 없습니다. 같은 버전 안에서 실행 설정을 맞춰 비교하는 것이 먼저입니다.
빠진 정리 코드가 드러난 Mock Service Worker 사례
발표 글의 Mock Service Worker 예시는 벤치마크가 보는 차이를 보여줍니다. 이 라이브러리는 자바스크립트에서 네트워크 요청을 가짜 응답으로 처리할 때 쓰입니다. 과제는 resetHandlers()를 호출해도 생성기 기반 응답이 처음부터 다시 시작하지 않는 버그를 고치는 일이었습니다. 생성기는 실행 상태를 보관하며 값을 차례로 내놓는 함수이므로 초기화 때 이전 실행 상태를 어떻게 처리할지도 문제가 됩니다.
Cognition이 공개한 Opus 5.5의 해답은 이전 생성기 참조를 버려 다음 요청에서 새 생성기를 만들었습니다. 신고된 증상만 보면 해결된 셈입니다. 그러나 이전 생성기를 닫지 않아 finally 블록의 정리 코드가 실행되지 않았습니다. 사용자가 그 안에서 자원을 반납하도록 작성했다면 누수나 일관성 문제가 남을 수 있습니다. 프롬프트가 정리 코드를 따로 요구하지 않았어도 기존 언어 동작과 라이브러리 맥락으로 유추해야 하는 부분입니다.
이 사례는 AI에게 모든 예외를 더 길게 적어주면 된다는 이야기로만 끝나지 않습니다. 실제 저장소에서는 작성자도 놓친 조건을 수정 과정에서 발견해야 합니다. FrontierCode 2.0은 이런 꼼꼼함에 해당하는 필수 조건을 이전 168개에서 501개로 늘렸습니다. 특정 입력만 고쳤는지, 비슷한 코드 경로를 함께 다뤘는지, 새 기능이 기존 지원 범위와 맞는지를 검토하는 기준으로도 읽을 수 있습니다.
근거 [1]
추론 강도를 높여도 항상 좋아지지 않는 이유
모델이 더 오래 생각하면 더 좋은 수정이 나온다고 기대하기 쉽습니다. FrontierCode는 올바른 코드를 더 많이 쓰는 것만으로 점수가 오르지 않는 구조입니다. 추가 변경이 요청 범위를 벗어나거나 기존 호환성을 깨면 오히려 실패할 수 있기 때문입니다. 발표 글은 추론 강도에 따른 성능이 항상 한 방향으로 오르지 않는 현상을 실제 사례와 함께 설명합니다.
PostHog 안드로이드 SDK 과제에서는 앱 시작 때 새 이벤트와 디스크에 저장된 이벤트를 두 모듈이 동시에 보내 순서가 엇갈리는 문제가 주어졌습니다. GPT-6 Astra의 낮은 추론 강도 실행은 캐시 로딩을 큐로 옮기고 기존 모듈의 전송 로직을 덜어내면서 공개 API는 유지했습니다. 반면 최대 강도 실행은 기존 클래스를 삭제하고 여러 파일로 책임을 분산하는 경향이 있었습니다. 경쟁 상태를 고쳐도 공개 API에 속한 클래스를 없애면 기존 앱에 불필요한 호환성 문제가 생깁니다.
이 예시에서 낮은 강도는 5회 중 5회, 최대 강도는 5회 중 1회 통과했습니다. 이것만으로 낮은 강도가 모든 작업에서 우월하다고 일반화할 수는 없습니다. 대신 큰 리팩터링이 필요한 작업인지, 작은 버그 수정을 안전하게 끝내야 하는 작업인지에 따라 설정을 나눌 근거가 됩니다. 2.0은 이전보다 허용 가능한 예상 밖 변경에 관대하도록 범위 기준도 조정했습니다. 많은 코드를 썼다는 이유 자체를 벌주는 것이 아니라, 저장소에 받아들일 수 있는 변경인지를 보려는 설계입니다.
근거 [1]
코딩 AI 점수와 실행 비용을 같이 비교하는 법
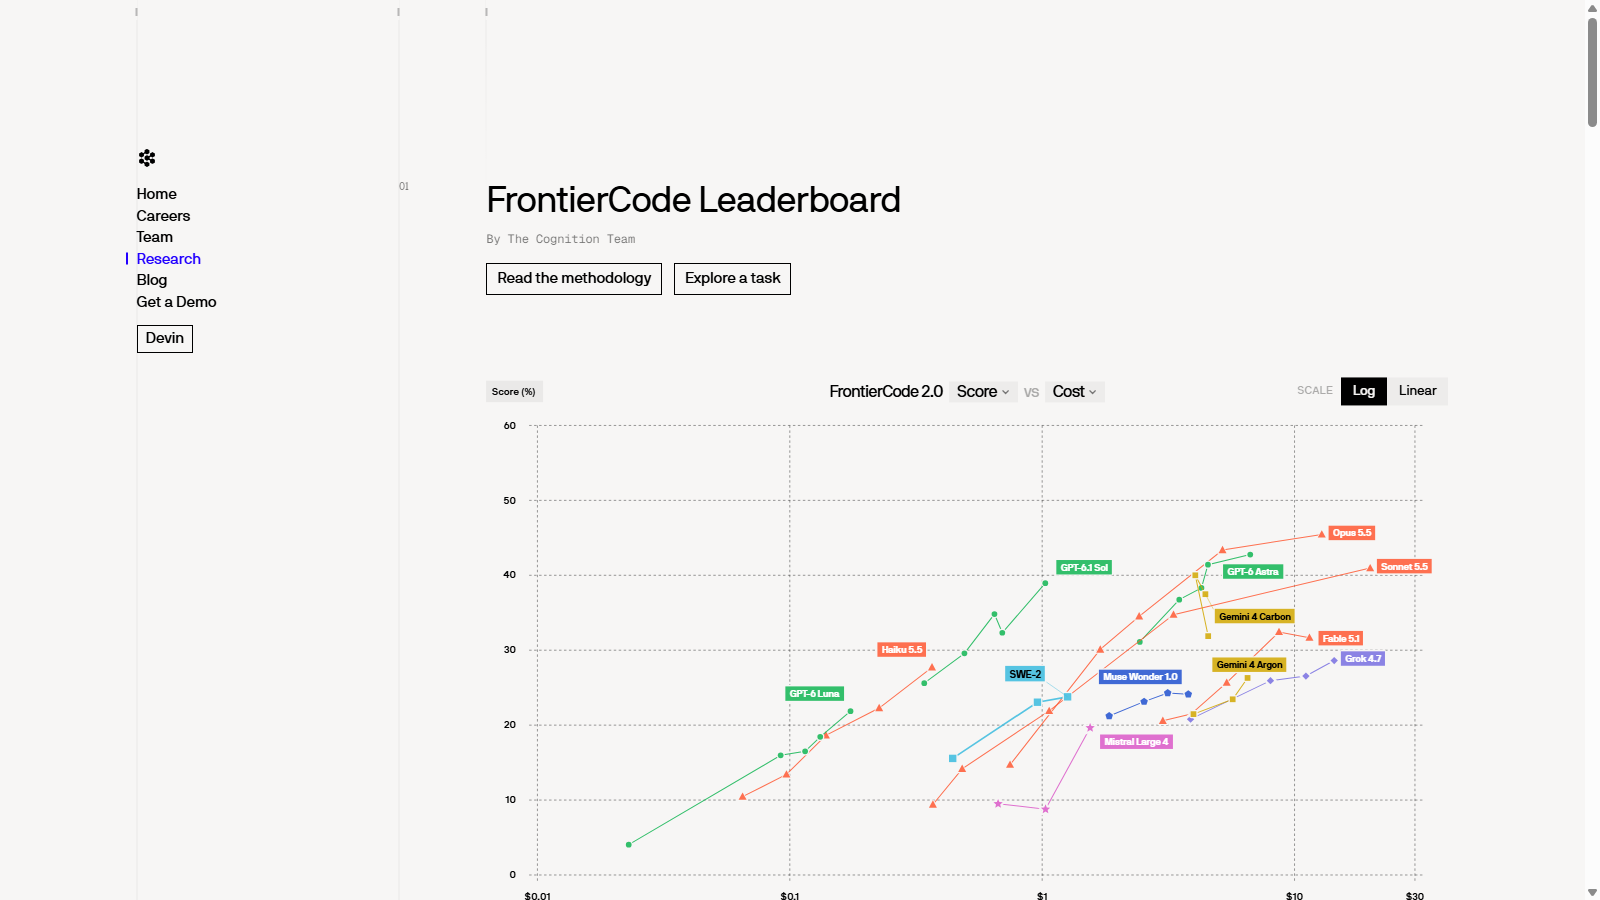
Cognition 순위표의 최고 점수 설정에서는 Opus 5.5가 45.5%, GPT-6 Astra가 42.8%, Sonnet 5.5가 41.0%입니다. 뒤이어 Gemini 4 Carbon이 40.0%, GPT-6.1 Sol이 39.0%입니다. 이는 Cognition의 실행 결과이며 독립 실험의 보편적인 순위가 아닙니다. 모델 이름 옆의 추론 강도와 Harness 열을 함께 봐야 합니다. Harness는 모델이 파일을 읽고 명령을 실행하도록 감싸는 에이전트 실행 도구를 가리킵니다.
예를 들어 Opus와 Sonnet은 Claude Code, GPT 계열은 Codex, Gemini 4 Carbon은 Devin CLI에서 평가됩니다. 모델과 실행 도구가 함께 달라지므로 차이를 전부 기초 모델 능력에 돌리기는 어렵습니다. 표의 최고 점수는 각 모델에서 가장 잘 나온 추론 강도를 고른 값이고, 같은 강도끼리의 결과만을 나란히 놓은 것도 아닙니다. 실제로 쓰는 도구와 조건에 가까운 행부터 보는 편이 낫습니다.
Cost / rollout은 공개 할인까지 반영한 정가 API 기준의 실행 한 번당 평균 달러 비용입니다. 구독료도, 성공한 수정 하나를 얻는 보장 가격도 아닙니다. 같은 표에서 GPT-6.1 Sol은 39.0%에 1.03달러, Gemini 4 Carbon은 40.0%에 4.04달러, Opus 5.5는 45.5%에 12.82달러로 표시됩니다. 점수 몇 퍼센트포인트를 더 얻는 데 얼마가 드는지 볼 수 있지만, 재시도와 사람의 검토 시간을 합친 실제 개발 비용은 별도로 계산해야 합니다.
순위표에서 설정과 부정 이용 비율까지 읽기
공개 리더보드는 Score와 Cost 축을 바꿔가며 실행 결과를 비교할 수 있습니다. 기본 비용 축은 로그 눈금이라 왼쪽에서 오른쪽으로 같은 거리만큼 움직여도 비용 차이가 단순한 덧셈으로 늘지 않습니다. 같은 점수라면 더 왼쪽, 같은 비용이라면 더 위에 놓인 실행이 유리하다는 식으로 먼저 읽고, 개별 모델을 골라 추론 강도에 따른 점들의 연결을 보는 순서가 이해하기 쉽습니다.
Best reasoning mode는 모델별 최고 점수 설정을, All reasoning levels는 여러 추론 강도의 결과를 보여줍니다. 단순 순위가 아니라 운영 예산에 맞는 설정을 고르려면 후자가 도움이 됩니다. 가장 높은 점수의 행만 고르면 더 저렴한 설정에서 얻을 수 있는 결과를 놓칠 수 있습니다. 반대로 가격이 싼 행만 고르면 실패한 수정 검토와 재시도 부담이 커질 수 있습니다.
Flag rate도 별도 항목입니다. 평가 중 인터넷에서 문서를 읽거나 오류를 검색하는 것은 허용되지만 원래 정답 PR처럼 해답을 담은 출처를 보는 실행은 감지해 0점 처리합니다. 따라서 인터넷 사용이 전면 금지된 평가와도 다릅니다. 플래그 비율은 부당한 인터넷 이용으로 표시된 실행의 비중이지 일반적인 오류율이 아닙니다. 순위표의 열 이름만 보고 테스트 실패율로 해석하지 않도록 구분해야 합니다.
근거 [2]
자기 저장소의 검토 기준으로 가져올 부분
개발 도구를 고를 때 이 결과는 최종 판정표보다 후보를 좁히는 자료에 가깝습니다. 자신의 코드베이스에 자주 생기는 수정 몇 가지를 정하고, 기존 버그를 재현하는 테스트와 공개 API 유지 여부를 함께 비교해야 합니다. 웹 화면을 새로 만드는 작업과 오래된 SDK의 호환성을 지키는 작업은 성공 기준이 다릅니다. 한 모델의 전체 점수가 높더라도 맡길 작업의 위험을 대신 판단해주지는 않습니다.
특히 버그 수정에서는 신고된 코드 경로 외에 같은 패턴이 반복되는 곳을 읽도록 요청하고, 수정 범위와 바꾸지 말아야 할 API를 구체적으로 남길 수 있습니다. 테스트가 새 기능의 정상 동작만 보는지, 잘못된 입력과 자원 정리, 이전 동작의 유지도 다루는지 살피는 일이 이어져야 합니다. 이것은 벤치마크 점수를 올리기 위한 요령이 아니라 발표 사례에서 드러난 실패를 실제 코드 리뷰 항목으로 옮기는 방법입니다.
모델 비교 결과를 보관할 때는 모델명뿐 아니라 버전, 추론 강도, 실행 도구와 비용 기준을 함께 적어두는 편이 좋습니다. 리더보드는 새 모델과 설정이 추가되는 살아 있는 자료라 순위 숫자만 떼어두면 비교 조건이 사라집니다. FrontierCode 2.0의 질문은 테스트가 초록색인지에서 끝나지 않습니다. 그 변경을 받아들였을 때 유지보수자가 떠안을 위험까지 줄었는지 살펴보는 데 의미가 있습니다.