모션브릭스 v0.2.0에서 달라진 공개 범위
캐릭터가 걷다가 의자에 앉게 하려면 걷기와 앉기 애니메이션만으로는 부족합니다. 의자로 접근하는 방향과 속도를 맞추고, 발이 미끄러지지 않도록 두 동작 사이를 이어야 합니다. 장애물 앞에서 몸을 낮추거나 달리다가 멈추는 상황까지 늘어나면 전환 클립과 연결 규칙도 함께 많아집니다. 엔비디아의 MotionBricks는 이 사이 움직임을 목표 포즈에 맞춰 생성하는 연구 모델입니다.
10월 23일 나온 v0.2.0의 변화는 사람 동작을 위한 SOMA 모델과 독립 저장소입니다. 앞선 공개는 GR00T Whole-Body Control 안의 Unitree G1 로봇용 프리뷰였고, 이번에는 사람과 로봇 모델을 같은 방식으로 다룰 수 있는 Python 실행 코드가 묶였습니다. 10월 27일 엔비디아 개발자 블로그도 사람 모델과 ONNX 배포, Newton 기반 예제를 이번 업데이트의 내용으로 소개했습니다.
웹에서 문장을 입력하면 완성된 동영상이 나오는 서비스와는 다릅니다. 게임이나 제작 도구가 목표 위치와 자세를 정하고, MotionBricks가 캐릭터의 현재 움직임에서 그 목표로 이어지는 구간을 만듭니다. 개발자가 자기 도구에 넣어 쓰는 동작 생성 부품에 가깝습니다.
One open model. 350,000+ motion clips. 15,000 FPS. MotionBricks from NVIDIA Research runs real-time character animation at scale, without hand-crafted transitions or fine-tuning. And yes, it works for robotics too. #SIGGRAPH2026 paper, demos + code: https://t.co/DqZrHxEBH7 https://t.co/UEajpjWTED
— NVIDIA AI (@NVIDIAAI) 2026년 6월 12일
최근 포즈 4개와 목표 포즈 4개로 잇는 움직임
입력은 최근 포즈 네 개와 목표 포즈 한 개에서 네 개입니다. 최근 포즈는 캐릭터가 어느 자세에 있고 어떤 속도로 움직이는지 알려주는 문맥입니다. 목표 한 개는 도착할 위치와 방향, 멈출 자세를 지정합니다. 목표를 더 주면 도착 순간의 속도나 가속, 운동량까지 표현할 수 있어 목표 지점을 통과하며 계속 움직이는 동작을 만들 수 있습니다.
모델 안에서는 세 부분이 일을 나눕니다. 루트 모듈은 몸 전체의 기준점이 이동할 경로와 구간 길이를 예측하고, 포즈 모듈은 그 경로를 따라갈 움직임을 압축된 토큰으로 만듭니다. 디코더는 토큰을 연속된 자세로 바꿉니다. 독자 입장에서는 화면에 보이는 뼈대가 곧바로 한 번에 생성되는 것이 아니라, 경로와 몸의 자세를 나눠 계산한다고 이해하면 됩니다.
출력 동작은 초당 30프레임 기준입니다. README가 설명하는 한 번의 생성 길이는 약 0.6초에서 1.9초로 짧습니다. 긴 장면은 생성한 동작을 재생하고 마지막 네 포즈를 다음 입력으로 돌려주며 이어갑니다. 게임 상태가 바뀌면 다음 목표도 바꿀 수 있지만, 다음에 무엇을 할지 선택하는 일은 여전히 호스트 애플리케이션의 몫입니다.
Inbetweener와 Scene Preview의 역할
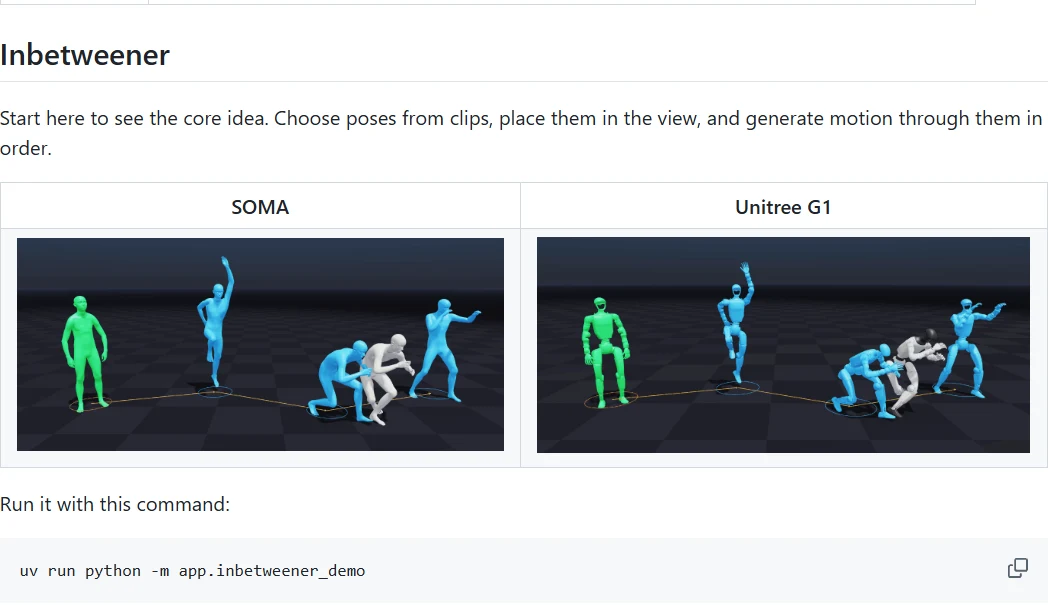
공개 예제는 두 가지 데모와 두 가지 편집기로 나뉩니다. Inbetweener는 기존 동작 클립에서 포즈를 고르고 화면에 배치한 뒤 그 사이를 잇는 가장 작은 예제입니다. 아래 사람과 로봇 화면을 보면 같은 인터페이스에서 서로 다른 뼈대를 다룬다는 점이 드러납니다. 처음부터 복잡한 게임 장면을 붙이는 대신 목표 자세를 바꿨을 때 연결 구간이 어떻게 달라지는지 살피는 용도입니다.
Scene Preview는 이 생성 과정을 연속 재생하는 쪽입니다. 캐릭터가 장면 안에서 걷고 달리고, 몸을 낮추거나 물체와 상호작용합니다. Skipping과 Zombie 등을 포함한 여섯 가지 이동 스타일도 예제에 있습니다. 전진만 되는 짧은 모션 클립을 만드는 기능과 달리, 방향과 자세를 바꾸며 이동하는 루프가 어떻게 구성되는지 보여줍니다.
사람은 SOMA, 로봇은 Unitree G1용 모델을 사용합니다. 실행 구조가 같아도 두 모델의 파일을 서로 바꿔 끼우는 것은 아닙니다. Hugging Face는 각 계열의 가중치와 설정, 보조 파일을 함께 보관하라고 안내합니다. SOMA 모델 카드의 뼈대는 관절 30개 기준이므로 기존 캐릭터의 관절 구성에 그대로 맞을 것이라고 전제해서도 안 됩니다.
Smart Primitive는 목표 자세를 재사용하는 단위
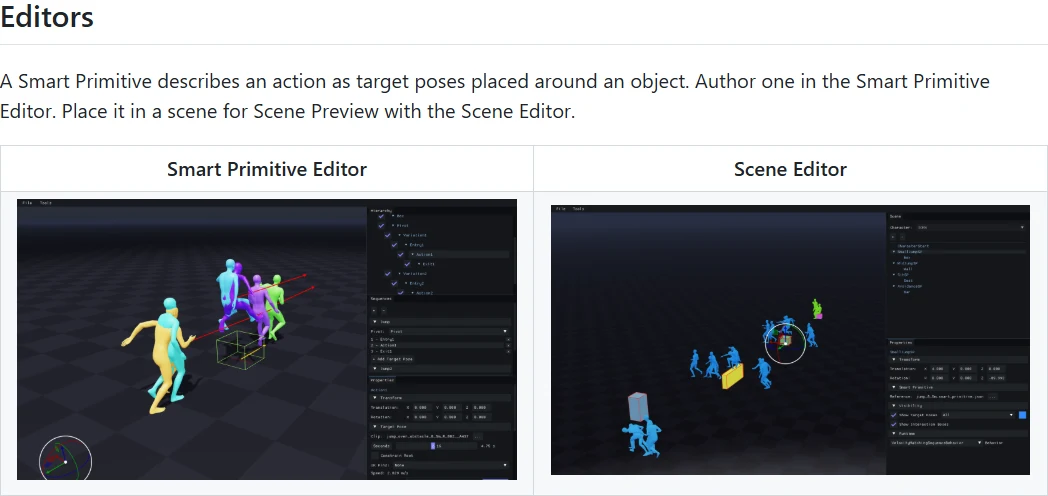
앉기나 장애물 넘기를 매번 포즈부터 다시 배치할 필요는 없습니다. Smart Primitive는 물체 주변에 놓인 목표 자세를 행동의 묶음으로 저장합니다. 같은 앉기 동작이라도 의자가 다른 위치에 있으면 목표를 그 물체에 맞게 놓고 연결 구간을 생성하는 식입니다. 행동을 추가할 때마다 모델을 새로 학습시키는 대신 목표 포즈의 구성을 재사용하는 접근입니다.
Smart Primitive Editor는 이 행동 단위를 만드는 도구이고, Scene Editor는 행동과 물체를 장면에 배치하는 도구입니다. 공식 튜토리얼도 포즈 사이 생성, 재사용 행동 제작, 장면 구성, 연속 재생 순으로 진행합니다. 편집기 두 개의 화면은 어떤 자세와 상호작용을 설계자가 준비하는지 보여줍니다. AI가 모든 행동 규칙을 스스로 알아내는 구조는 아닙니다.
이 방식에서는 작업의 중심이 전환 클립을 하나씩 만드는 일에서 적절한 목표를 정의하는 일로 옮겨갑니다. 예를 들어 장애물 밑으로 지나가려면 어느 위치에서 얼마나 몸을 낮춰야 하는지 애플리케이션이 정해야 합니다. 모델은 연결 움직임을 만들지만 장애물의 의미나 게임의 성공 조건을 대신 설계하지 않습니다. 편집 시간 단축 가능성과 별개로 목표 배치의 품질은 결과에 직접 영향을 줍니다.
NVIDIA GPU와 ONNX 배포의 실제 조건
공개 실행 코드는 Warp, Newton, TensorRT를 사용합니다. TensorRT 기반 데모에는 NVIDIA GPU가 필요하고, 엔비디아가 명시한 시험 환경은 Windows와 Linux의 x86-64 시스템 및 GeForce RTX 4090입니다. 이를 모든 엔비디아 GPU에서 같은 속도가 나온다는 보증이나 RTX 4090이 절대적인 최소 사양이라는 뜻으로 읽으면 안 됩니다. 자신의 장비에서 동작과 메모리 사용량을 따로 평가할 필요가 있습니다.
저장소에는 데모용 ONNX 모델이 포함돼 있습니다. 예제를 실행하는 것만 목적이라면 Hugging Face의 SafeTensors 체크포인트를 추가로 받을 필요가 없습니다. 다른 실행 환경을 만들거나 ONNX를 새로 내보낼 때 가중치 패키지와 변환 도구를 쓰게 됩니다. 모델 카드는 약 2억 개 매개변수와 FP32 및 혼합 FP16 형식을 설명하며, 두 정밀도는 같은 입력과 출력 인터페이스를 사용합니다.
설치 안내는 Git LFS와 uv를 준비한 뒤 저장소 루트에서 git lfs pull과 uv sync를 실행하는 흐름입니다. 모델과 정밀도 조합별 첫 실행에는 TensorRT 실행 계획을 만드는 데 몇 분이 걸리고, 이후에는 .trt-cache에 저장된 결과를 재사용합니다. 언어 모델용 Transformers의 from_pretrained에 경로를 넣는 방식은 아닙니다. 웹 채팅 서비스의 구독료나 호출 횟수와 비교하기보다 로컬 GPU를 쓰는 개발 의존성으로 보아야 합니다.
언리얼 데모와 공개 Python 코드의 차이
연구 페이지에는 언리얼 엔진에서 캐릭터가 장면을 오가며 여러 물체와 상호작용하는 영상이 있습니다. 다만 엔비디아 개발자 블로그는 그 영상에 쓰인 언리얼 통합 코드가 이번 배포에 포함되지 않는다고 명시합니다. 저장소를 내려받으면 같은 장면이 언리얼 프로젝트로 열리거나 플러그인을 추가하는 것으로 통합이 끝난다는 뜻이 아닙니다.
이번 공개 구현은 연구 아이디어를 Newton 뷰어와 Python 코드로 살펴볼 수 있게 만든 참고 구현입니다. Scene Preview는 언리얼 연구 데모의 원리를 작은 실행 코드로 옮긴 예제이며, 개발자가 자기 엔진이나 제작 파이프라인에 넣으려면 캐릭터 뼈대, 좌표계, 목표 선택과 재생 루프를 연결해야 합니다. 공식 튜토리얼도 네 가지 앱을 완제품 도구 모음이 아닌 통합 방법을 보여주는 예제라고 설명합니다.
따라서 3D 제작자에게 필요한 부분과 게임 개발자에게 필요한 부분이 다릅니다. 제작자는 목표 자세로 동작을 탐색하는 흐름을 평가할 수 있고, 게임 개발자는 런타임에서 목표를 계속 갱신하는 구조를 검토할 수 있습니다. 이미 쓰는 엔진에서 곧바로 상용 배포할 수 있는 편집 기능을 찾는 경우라면 공개 범위의 차이를 먼저 따져야 합니다.
상업 이용은 코드와 모델, 샘플을 나눠 판단
오픈소스라는 표현 하나로 저장소 안의 모든 파일을 같은 조건으로 사용할 수는 없습니다. 코드는 Apache 2.0이고 모델 가중치와 ONNX 파일은 NVIDIA Open Model Agreement를 따릅니다. 모델 안내는 계약 조건에 따른 상업 이용과 수정 모델 재배포를 허용한다고 적고 있습니다. 코드의 라이선스만 보고 모델과 데이터에도 같은 허락이 적용된다고 판단하면 범위가 달라집니다.
특히 예제 동작은 따로 봐야 합니다. 저장소에 포함된 Bones 유래 사람 BVH와 로봇 CSV 샘플은 NVIDIA 기술의 내부 평가와 시험을 위한 Sample Data Evaluation License 대상입니다. 모델을 상업적으로 쓸 수 있다는 사실이 그 예제 클립을 게임에 넣어 판매할 수 있다는 뜻은 아닙니다. 샘플 고지는 대상 파일을 사람 BVH 38개와 G1 CSV 37개로 구체적으로 나열합니다.
문서와 NVIDIA가 제작한 이미지 및 영상은 CC BY 4.0으로 공개돼 있습니다. 의존 라이브러리와 로봇 자산은 각자의 조건이 남습니다. 상용 도입에서는 사용할 파일을 코드, 모델, 동작 데이터, 외부 자산으로 나누고 해당 고지를 따라가는 편이 안전합니다. 새로운 모델 출력의 활용 가능성과 배포 패키지에 포함할 원본 파일의 이용 조건은 별도 문제입니다.
| 구성 | 적용 조건 | 도입 전 구분할 점 |
|---|---|---|
| 소스 코드 | Apache 2.0 | 코드의 조건이 모델과 데이터까지 바꾸지는 않음 |
| SOMA 및 G1 모델 | NVIDIA Open Model Agreement | 계약 조건에 따라 상업 이용 및 수정 모델 재배포 허용 |
| Bones 유래 예제 동작 | NVIDIA Sample Data Evaluation License | NVIDIA 기술의 내부 평가와 시험 용도 |
| NVIDIA 문서와 미디어 | CC BY 4.0 | 저작자와 라이선스를 표시하는 조건 |
MotionBricks README와 Hugging Face 모델 안내의 구성별 이용 조건
로봇을 움직이는 제어기와는 다른 모델
Unitree G1 모델이 있다는 점 때문에 실제 로봇에 바로 연결할 수 있다고 생각하기 쉽습니다. 하지만 MotionBricks의 출력은 목표 자세로 이어지는 움직임이지 모터 명령이 아닙니다. Hugging Face 모델 안내는 실제 하드웨어 실행에 별도의 추적 제어기, 로봇 한계 검사와 안전성 평가가 필요하다고 분리합니다. 화면에서 균형 잡힌 동작처럼 보여도 물리 장비에서 같은 결과를 보장하지 않습니다.
학습 재현의 범위에도 차이가 있습니다. 이번 가중치 패키지는 추론용 가중치와 메타데이터를 제공하지만 원래 학습을 이어가는 데 필요한 옵티마이저 상태나 전체 학습 데이터, 학습 파이프라인은 포함하지 않습니다. 사람 모델을 받아 자기 데이터로 즉시 원래 학습을 재개할 수 있는 배포본은 아닙니다. 과거 로봇 프리뷰의 구성과 새 독립 저장소를 섞어 읽지 않는 것이 중요합니다.
지금 이 공개본이 맞는 대상은 목표 포즈 기반 동작 생성을 자기 애플리케이션에 연결하려는 개발자와 연구자입니다. 먼저 짧은 포즈 전환의 품질을 보고, 연속 이동과 물체 상호작용으로 범위를 넓힐 수 있습니다. 완성된 언리얼 플러그인이나 실제 로봇의 안전 제어까지 기대하는 용도와는 출발점이 다릅니다.